Srovnání zachycuje dvanáct modelů umělé inteligence podle průtoku v tokenech za sekundu, latence do prvního tokenu a indexu inteligence. Téma je aktuální v říjnu 2026, kdy firmy vybírají mezi pohotovou odezvou pro zákazníky a hlubším uvažováním pro agenty. Data čteme jako laboratorní mediány, které pomáhají rozlišit interaktivní dialog, průběžné agentní kroky a dávkové zpracování.
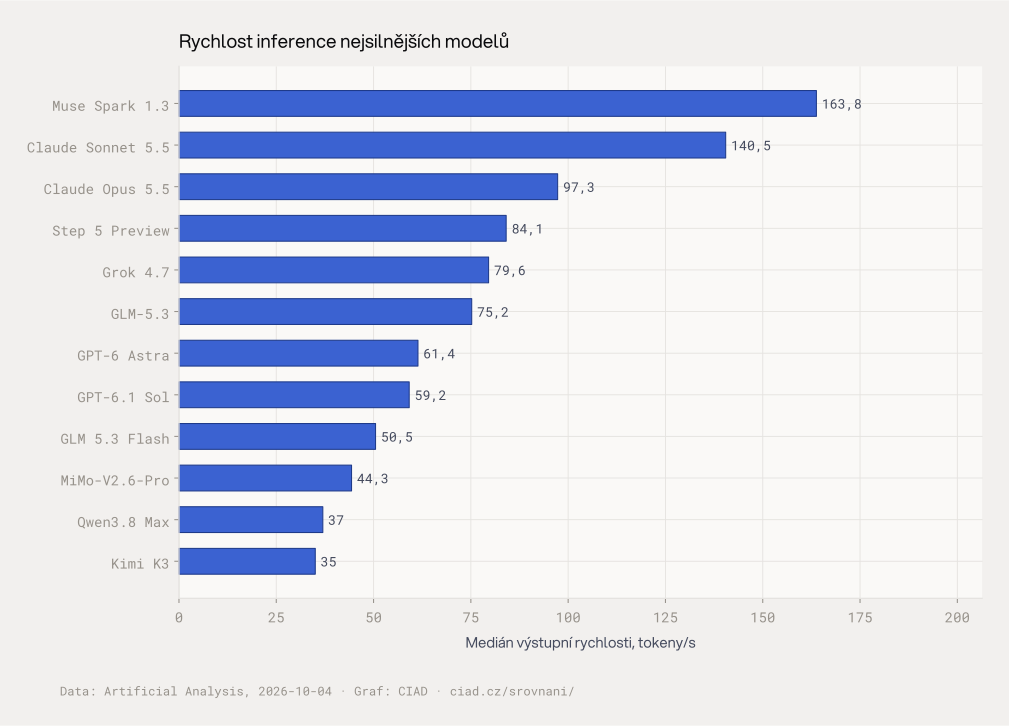 Medián tokenů za sekundu.
Průtok vede, odezva rozhoduje
V čele pořadí stojí Muse Spark 1.3 s průtokem 163,8 a latencí 45,91 s při inteligenci 48,1. Následuje Claude Sonnet 5.5 s průtokem 140,5 a latencí 263,18 s při inteligenci 56 a dále Claude Opus 5.5 s průtokem 97,3 a latencí 449,11 s při inteligenci 57,6. Za nimi se řadí Step 5 Preview s průtokem 84,1 a latencí 1,92 s při inteligenci 43,7, Grok 4.7 s průtokem 79,6 a latencí 22,45 s při inteligenci 46,4 a GLM-5.3 s průtokem 75,2 a latencí 2,7 s při inteligenci 44,8.
Střed pořadí tvoří GPT-6 Astra s průtokem 61,4 a latencí 163,86 s při inteligenci 52,7 a GPT-6.1 Sol s průtokem 59,2 a latencí 154,2 s při inteligenci 51,8. Dále pokračuje GLM 5.3 Flash s průtokem 50,5 a latencí 2,97 s při inteligenci 41,8 a MiMo-V2.6-Pro s průtokem 44,3 a latencí 4,03 s při inteligenci 46,3. V závěru pořadí je Qwen3.8 Max s průtokem 37 a latencí 1,72 s při inteligenci 45,4 a Kimi K3 s průtokem 35 a latencí 2,62 s při inteligenci 43,6. Rozdíl mezi čelem a závěrem dokládá předpočítaná hodnota 4,7×.
Co rychlost říká o provozu
Průtok v tokenech za sekundu popisuje, jak plynule model sype odpověď po jejím zahájení, zatímco latence popisuje čekání na začátek. Zápis s průtokem 163,8 a latencí 45,91 s se proto hodí jinam než zápis s průtokem 37 a latencí 1,72 s. První z nich udrží dlouhé generování, druhý potěší okamžitou reakcí. Právě napětí mezi těmito dvěma metrikami je podstatou volby mezi živým dialogem a dávkovým zpracováním.
Index inteligence čteme jako doprovodný údaj ke každému řádku, nikoli jako vstupenku k nasazení. U Claude Opus 5.5 je uvedeno 57,6 s latencí 449,11 s, u GPT-6 Astra je uvedeno 52,7 s latencí 163,86 s a u Step 5 Preview je uvedeno 43,7 s latencí 1,92 s. V provozu pak rozhoduje trpělivost uživatele, délka kontextu, chování nástrojů a cena čekání. Laboratorní medián neříká, jak se latence rozpadne při špičce, ani jak působí na důvěru zákazníka.
Jak vybrat model pro firmu
Pro živý dialog se dívejte nejprve na latenci a teprve potom na průtok. Hodnoty 1,92 s, 2,7 s, 2,97 s, 4,03 s, 1,72 s a 2,62 s patří k pohotovějšímu konci sledovaného rozpětí, zatímco hodnoty 45,91 s, 263,18 s, 449,11 s, 163,86 s a 154,2 s znamenají znatelný nástup s delším čekáním. U agentních úloh sledujte vyváženost všech tří údajů, protože opakované volání násobí každé zaváhání na startu.
Pro dávkové zpracování je latence podružná a rozhoduje stabilní průtok v dlouhém běhu. Tam dává smysl pořadí od hodnoty 163,8 přes 140,5 a 97,3 až po 35, vždy s přihlédnutím k inteligenci 48,1 či 56 či 57,6 či 41,8. V české organizaci doporučujeme ověřit si vítěze z grafu na vlastních dotazech, měřit spokojenost s odezvou a smluvně hlídat špičky. Graf berte jako vodítko pro užší výběr, nikoli jako konečný verdikt.
Časté dotazy
Který AI model je nejrychlejší v tokenech za sekundu?
V čele sledovaného pořadí stojí Muse Spark 1.3 s průtokem 163,8 tokenu za sekundu, za ním následuje Claude Sonnet 5.5 s průtokem 140,5 a Claude Opus 5.5 s průtokem 97,3. V závěru pořadí je Kimi K3 s průtokem 35 a Qwen3.8 Max s průtokem 37. Předpočítaná hodnota 4,7× dokládá odstup mezi čelem a závěrem sledované dvanáctky.
Jaká je latence TTFT u sledovaných AI modelů?
Latence se pohybuje ve sledovaném rozpětí 1,72 až 449,11 s. U Qwen3.8 Max je uvedeno 1,72 s a u Step 5 Preview je uvedeno 1,92 s, zatímco u Claude Opus 5.5 je uvedeno 449,11 s a u Claude Sonnet 5.5 je uvedeno 263,18 s. Pro živý dialog jsou podstatné právě tyto rozdíly v nástupu odpovědi, nikoli pouze samotný průtok.
Jak vybrat AI model podle rychlosti a inteligence?
Pro živý dialog hledejte pohotovou latenci, například 1,72 s či 2,7 s, pro dávkové zpracování sledujte průtok, například 163,8 či 140,5. Inteligenci čtěte vždy u konkrétního řádku, například 48,1 u Muse Spark 1.3 či 52,7 u GPT-6 Astra. Vhodného kandidáta ověřte na vlastních dotazech a podle spokojenosti s odezvou v běžném provozu.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 4. října 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.