Tento článek srovnává dva aktuální vlajkové modely: Claude Fable 5.1 od Anthropic a Grok 4.6 od xAI. Data pocházejí z benchmarkových měření provedených v září 2026 a zachycují souhrnné indexy inteligence a kódování, hloubkové testy expertních znalostí, vědeckého programování a dlouhého kontextu, dále cenu za milion tokenů, generovací rychlost a čas k prvnímu tokenu. Cílem je ukázat, který model se pro jaký typ nasazení reálně vyplatí.
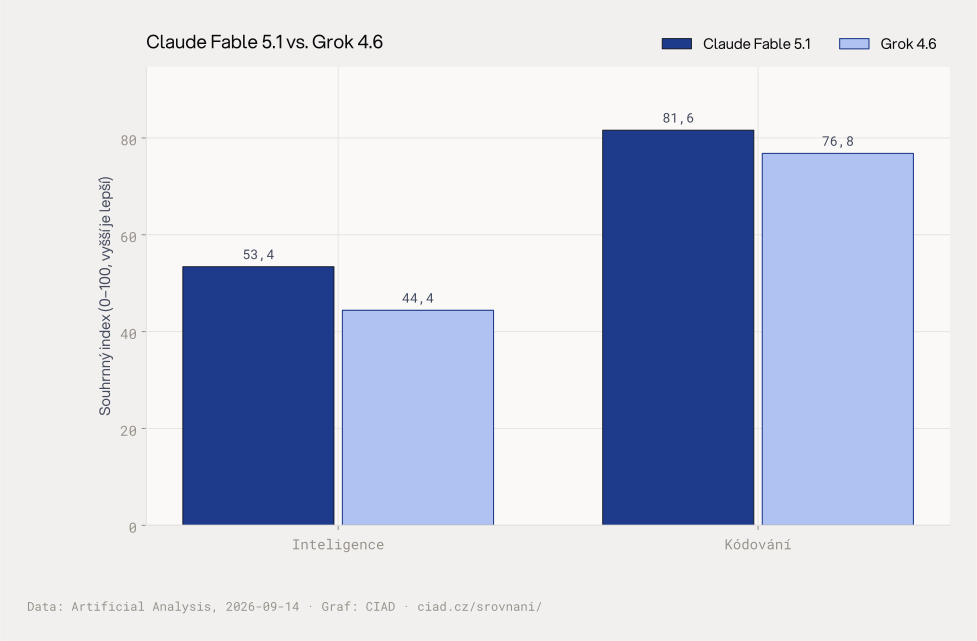 Souhrnné indexy: inteligence, kódování.
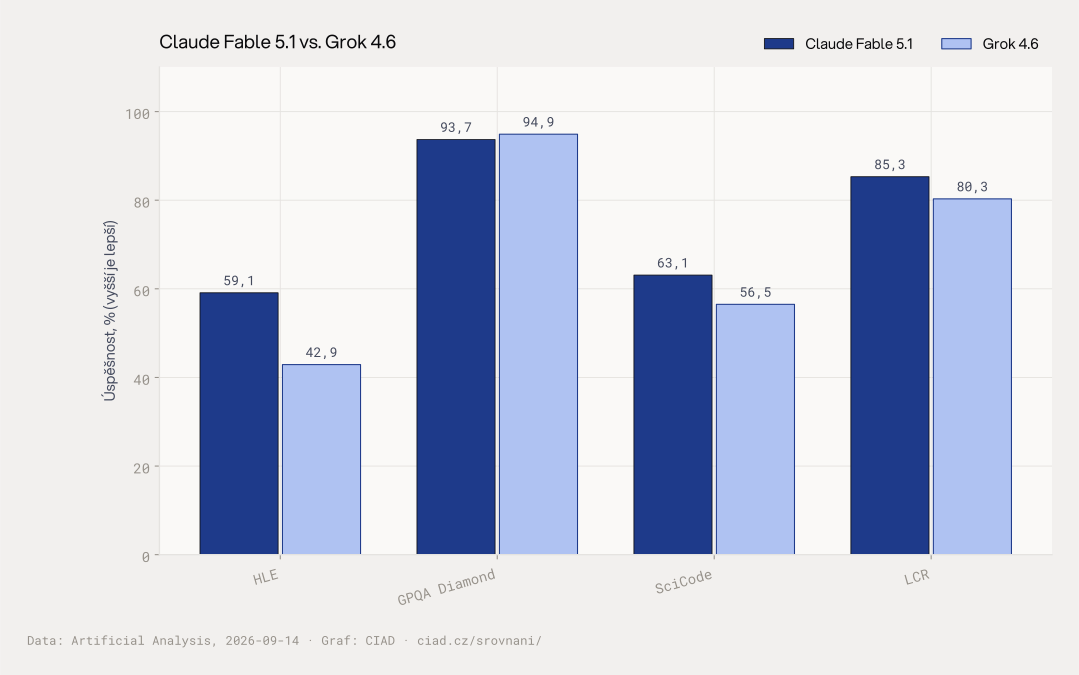 Hloubkové benchmarky: HLE, GPQA Diamond, SciCode, LCR.
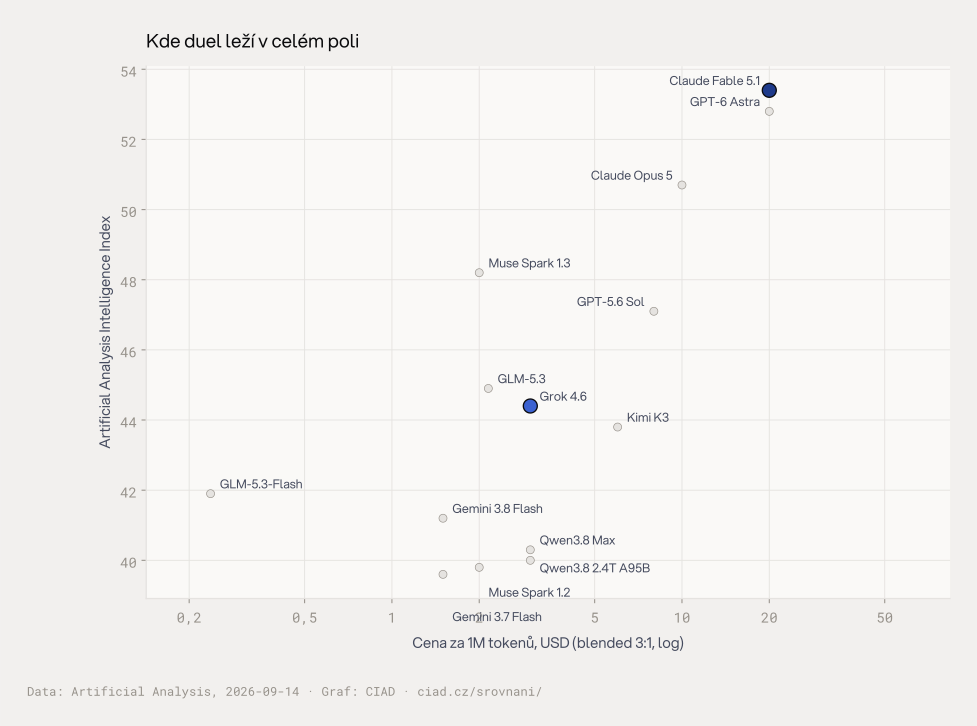 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Co ukazují souhrnné indexy a benchmarky
V souhrném indexu inteligence dosahuje Claude Fable 5.1 hodnotu 53,4, zatímco Grok 4.6 dosahuje 44,4, rozdíl indexu inteligence podle předpočtu činí 9 bodů. V indexu kódování vede Claude Fable 5.1 s 81,6 oproti 76,8 Groku 4.6. Pořadí řádků ve faktu potvrzuje, že Claude Fable 5.1 vede v obou souhrnných metrikách.
Hloubkové benchmarky odhalují diferencovanější obraz. V testu HLE, který měří expertní otázky napříč obory, dosahuje Claude Fable 5.1 59,1 % a Grok 4.6 42,9 %, největší náskok Clauda podle předpočtu je 16,2 procentního bodu. V GPQA Diamond, měřícím vědecké otázky doktorandské úrovně, vede Grok 4.6 s 94,9 % nad Claudem 5.1 s 93,7 %, největší náskok Groku je 1,2 procentního bodu. SciCode, test programování vědeckých algoritmů, ukazuje 63,1 % pro Clauda a 56,5 % pro Groka. LCR, porozumění dlouhému kontextu, vykazuje 85,3 % u Clauda a 80,3 % u Groku.
U provozních parametrů generuje Grok 4.6 71,3 tokenů za sekundu, Claude Fable 5.1 69,7 tokenů za sekundu, poměr rychlostí podle předpočtu je 1×. Čas k prvnímu tokenu (TTFT) je u Groku 4.6 45,85 vteřin, u Clauda 5.1 118,06 vteřin. Cena za milion tokenů u Clauda 5.1 činí 20 USD, u Groku 4.6 3 USD, poměr cen podle předpočtu je 6,7×.
Kritická interpretace výsledků praxe
Výsledky indexů inteligence a kódování naznačují, že Claude Fable 5.1 disponuje širšími schopnostmi pro složité úlohy vyžadující hluboké úvahy a přesné dodržování zadání. Rozdíl devíti bodů v indexu inteligence se projeví zejména u autonomních agentů, které musí řetězit rozhodnutí, a u práce v terminálu, kde se chyby kumulativně násobí. Vyšší skóre v kódování 81,6 podporuje generování produkčně připraveného kódu s menším počtem iterací.
Hloubkové benchmarky přinášejí nüance. Výhra Clauda v HLE s 59,1 % oproti 42,9 % signalizuje lepší orientaci v interdisciplinárních expertních otázcích, což je relevantní pro vědu a výzkum při průzkumu literatury a formulaci hypotéz. Těsný odstup v GPQA Diamond (93,7 % vs 94,9 %) ukazuje, že oba modely zvládají vědecké otázky doktorandské úrovně na podobné úrovni, pro reálnou výzkumnou práci je rozdíl marginální. Převaha Clauda v SciCode (63,1 % vs 56,5 %) a LCR (85,3 % vs 80,3 %) zlepšuje spolehlivost při programování vědeckých algoritmů a zpracování dlouhých dokumentů.
Provozní parametry obrátí perspektivu. Grok 4.6 nabízí rychlejší první token (45,85 s vs 118,06 s) a srovnatelnou generativní rychlost, což pro interaktivní aplikace a chatová rozhraní znamená výrazně lepší uživatelský zážitek. Cena 3 USD za milion tokenů oproti 20 USD dělá Grok 4.6 ekonomicky atraktivním pro vysokovýkonná nasazení, kde se objem tokenů počítá v milionech denně. Laboratorní benchmarky nezachycují náklady na infrastrukturu ani latenci v reálném provozu pod zátěží.
Doporučení pro české organizace
Pro české firmy a organizace platí: pokud je rozhodujícím faktorem maximální kvalita výstupu u složitých analytických úloh, vědeckého programování a práce s dlouhými dokumenty, Claude Fable 5.1 odůvodňuje svou cenu. Jeho silné stránky v HLE, SciCode a LCR přeloží do menšího ručního korektování a vyšší spolehlivosti v produkci.
Když dominuje objem požadavků, citlivost na cenu a rychlost odezvy v interaktivních scénářích, Grok 4.6 představuje racionálnější volbu. Jeho výkon v GPQA Diamond a srovnatelná generativní rychlost při zlomku ceny umožňují škálovat nasazení bez lineárního nárůstu nákladů. Univerzálního vítěze data nepodporují, výběr závisí na váze přiřazené kvalitě versus nákladům a latenci.
Časté dotazy
Který model je chytřejší podle indexu inteligence?
Claude Fable 5.1 dosahuje indexu inteligence 53,4, Grok 4.6 index 44,4, rozdíl podle předpočtu činí 9 bodů. Claude Fable 5.1 tak vede v souhrnné inteligenci a je vhodnější pro úlohy vyžadující hluboké úvahy.
Kolik stojí Grok 4.6 oproti Claudi Fable 5.1?
Cena za milion tokenů u Groku 4.6 je 3 USD, u Clauda Fable 5.1 20 USD, poměr cen podle předpočtu je 6,7×. Grok 4.6 je výrazně levnější pro vysokovýkonná nasazení.
Který model je rychlejší v generování odpovědi?
Grok 4.6 generuje 71,3 tokenů za sekundu, Claude Fable 5.1 69,7 tokenů za sekundu, poměr rychlostí podle předpočtu je 1×. Grok 4.6 má kratší čas k prvnímu tokenu 45,85 vteřin versus 118,06 vteřin.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 14. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.