Dva nové hraniční modely vyšly ve stejném týdnu září 2026 a okamžitě nastolily novou referenční rovinu. Anthropic uvedl Claude Opus 5.5, xAI odpověděl Grok 4.7. Srovnání vychází z jednotné sady metrik: souhrnný index inteligence, tři specializované benchmarky a cena za milion tokenů. Data odrážejí stav k 22. září 2026, kdy oba modely byly k dispozici pro komerční použití.
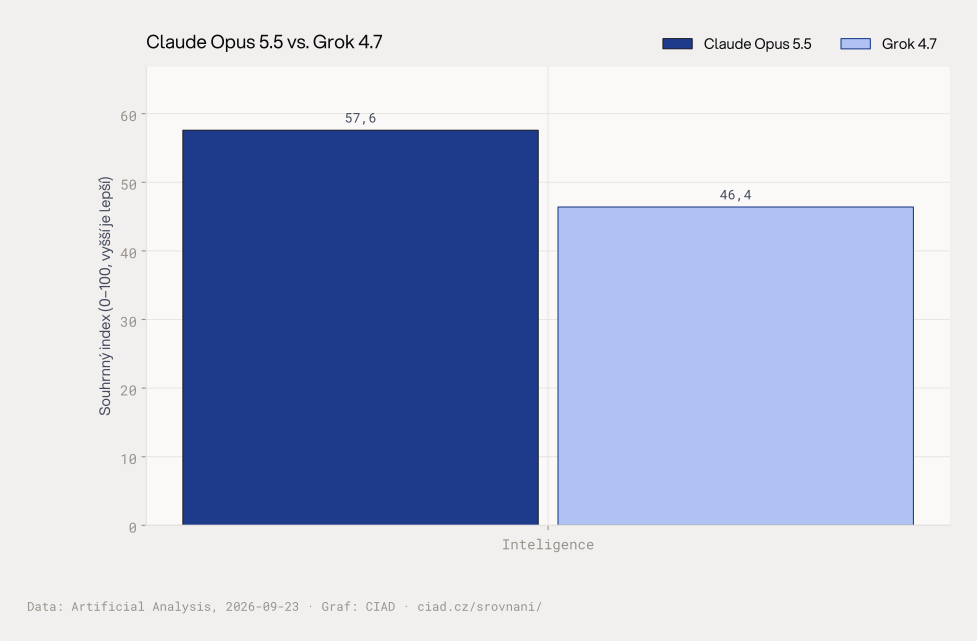 Souhrnné indexy: inteligence.
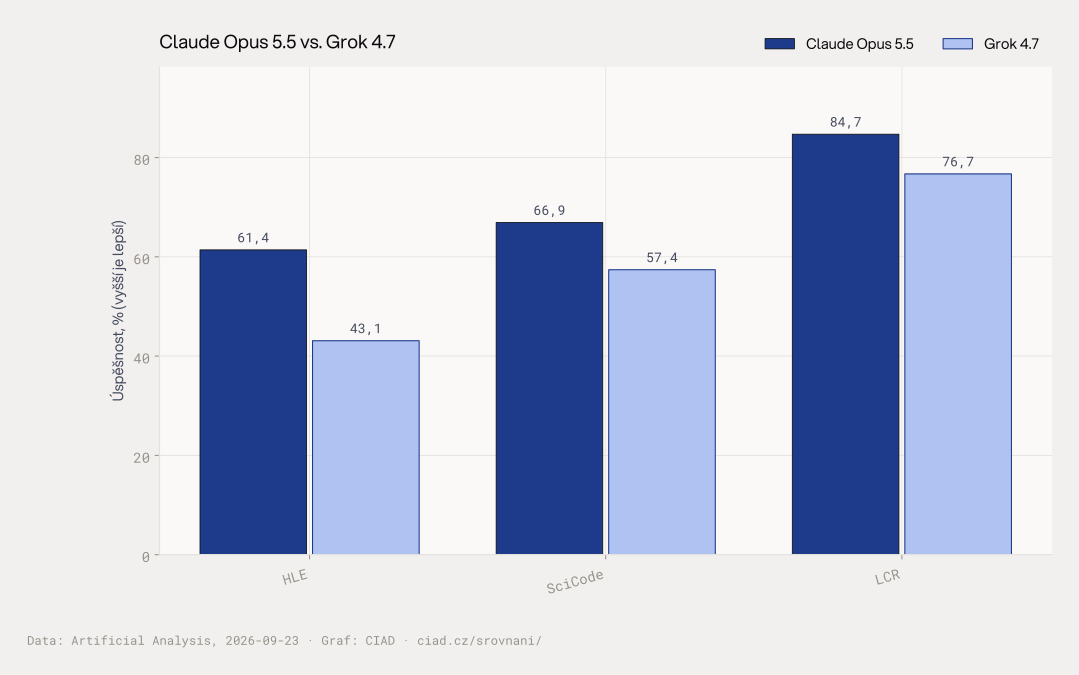 Hloubkové benchmarky: HLE, SciCode, LCR.
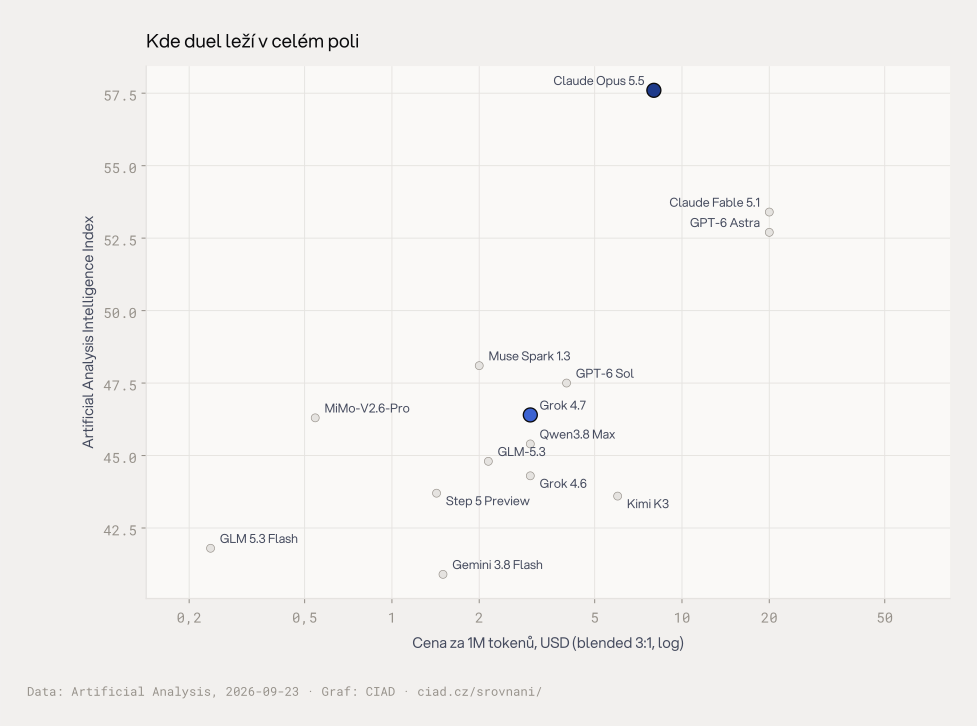 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Co ukazují souhrnná data
Claude Opus 5.5 dosahuje indexu inteligence 57,6, Grok 4.7 se zastaví na 46,4. Rozdíl 11,2 bodu potvrzuje jasné vedení Clauda v celkovém hodnocení. U hloubkových benchmarků Claude vede ve všech třech: HLE měří expertní otázky napříč obory, kde Claude dosahuje 61,4 % a Grok 43,1 %. SciCode testuje programování vědeckých algoritmů, zde Claude 66,9 % proti 57,4 %. LCR posuzuje porozumění dlouhému kontextu, Claude 84,7 %, Grok 76,7 %. Největší náskok Clauda je v HLE s 18,3 procentním bodem, což signalizuje silnější schopnost syntetizovat znalosti napříč disciplínami.
Cenově je Grok 4.7 výrazně přístupnější: 3 USD za milion tokenů proti 8 USD u Clauda. Poměr cen 2,7× znamená, že za cenu jednoho volání Clauda lze získat téměř tři volání Groku. Pro aplikace s vysokým objemem tokenů a menšími nároky na hloubkový rozum může tato diference být rozhodující.
Kritická interpretace výsledků
Index inteligence a benchmarky jsou laboratorní měření. HLE testuje odpovědi na expertní otázky, což koreluje s vědeckým výzkumem a strategickým plánováním, ale ne zaručuje spolehlivost v produkci. SciCode měří implementaci vědeckých algoritmů · relevantní pro vývoj simulací a numerických knihoven, méně pro běžné aplikační kódování. LCR s 84,7 % Clauda a 76,7 % Groku ukazuje, že oba modely dobře drží kontext stovek tisíc tokenů, rozdíl osm procentních bodů se v praxi projeví jen u nejdelších dokumentů nebo velmi složitých instrukcí.
Podle mediálního monitoringu Anthropic prohlásil, že Opus 5.5 dosahuje úrovně Fable 5.1 při 40 % nižších nákladech než Opus 5. Ars Technica mluví o „fázi porovnávání nákupů“, Simon Willison poznamenal, že oba modely vyšly ve stejném dni jako GPT-6 Sol a Luna. Tyto informace kontextualizují data: trh se posouvá k dostupnějším variantám topové inteligence, ale benchmarky samy o sobě neodhalují latenci, dostupnost API ani stabilitu výstupů v reálném provozu.
Co z toho plyne pro praxi
Pro české firmy a organizace platí: pokud je rozhodující maximální kvalita výstupu při složitých analytických úlohách, vědeckém výzkumu nebo dlouhých dokumentech s náročné instrukcí, Claude Opus 5.5 je jasná volba navzdory vyšší ceně. Pokud jde o masové zpracování textu, klasifikaci, extrakci nebo generování obsahu, kde stačí dobrá a ne nejlepší inteligence, Grok 4.7 nabízí výrazně lepší poměr výkonu k nákladům. Hybridní strategie · Claude pro kritické kroky, Grok pro objemové předzpracování · může být pro mnoho týmů optimální.
Doporučujeme pilotní test na reprezentativní sadě vlastních úkolů. Benchmarky dávají směr, ale konkrétní promptování, formát výstupu a integrační omezení často mění pořadí modelů v reálném nasazení.
Časté dotazy
Který model je chytřejší podle indexu inteligence?
Claude Opus 5.5 dosahuje indexu 57,6, Grok 4.7 index 46,4. Rozdíl je 11,2 bodu ve prospěch Clauda.
Kolik stojí Grok 4.7 oproti Claudi Opus 5.5?
Grok 4.7 stojí 3 USD za milion tokenů, Claude Opus 5.5 stojí 8 USD. Poměr cen je 2,7× ve prospěch Groku.
Ve kterém benchmarku je rozdíl největší?
Největší náskok Clauda je v HLE s 18,3 procentním bodem (61,4 % proti 43,1 %). HLE měří expertní otázky napříč obory.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 23. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.