Dva modely dělí v souhrnném indexu inteligence náskok 4,9 bodu ve prospěch Claude Opus 5.5 s hodnotou 57,6 proti hodnotě 52,7, přičemž následuje GPT-6 Astra. Poměr cen 2,5× a poměr rychlostí 1,5× však otáčejí úvahu k provozu. Podle mediálního monitoringu tvůrci zároveň řešili dostupnost v regulovaném prostředí a původ textu. Žádný univerzální vítěz z dat neplyne.
Srovnáváme dva modely Claude Opus 5.5 od Anthropic a GPT-6 Astra od OpenAI v situaci, kdy laboratoře slibují univerzální nasazení a české organizace řeší vědu a výzkum, dlouhé dokumenty a cenu provozu. Vycházíme ze souhrnných indexů inteligence, ceny a rychlosti a ze tří hloubkových zkoušek s úspěšností v procentech. Každou zkoušku stručně vysvětlujeme a ukazujeme její praktický význam.
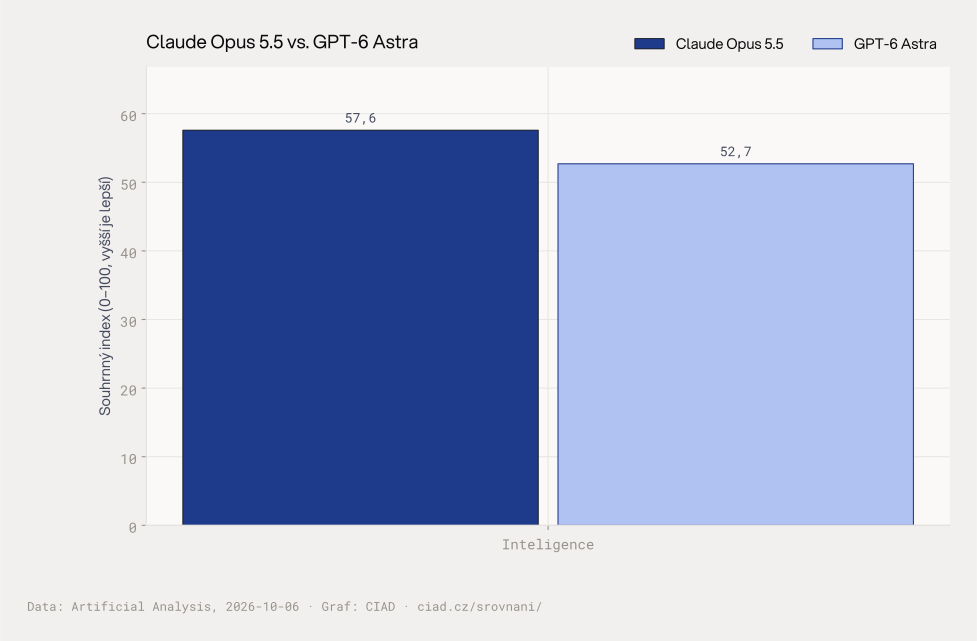 Souhrnné indexy: inteligence.
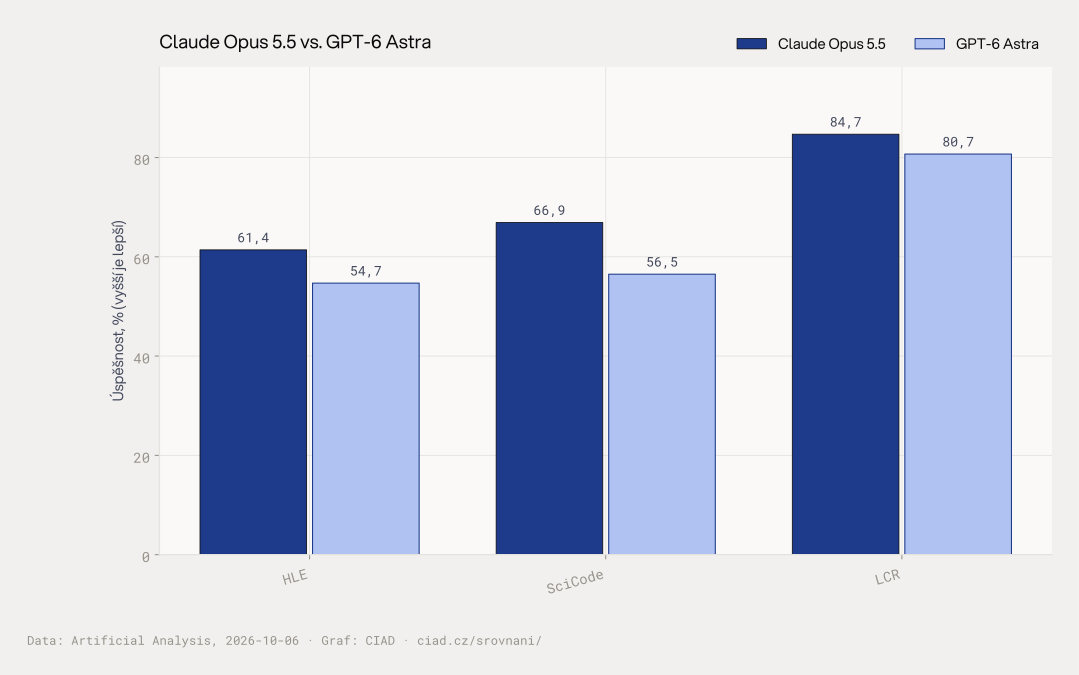 Hloubkové benchmarky: HLE, SciCode, LCR.
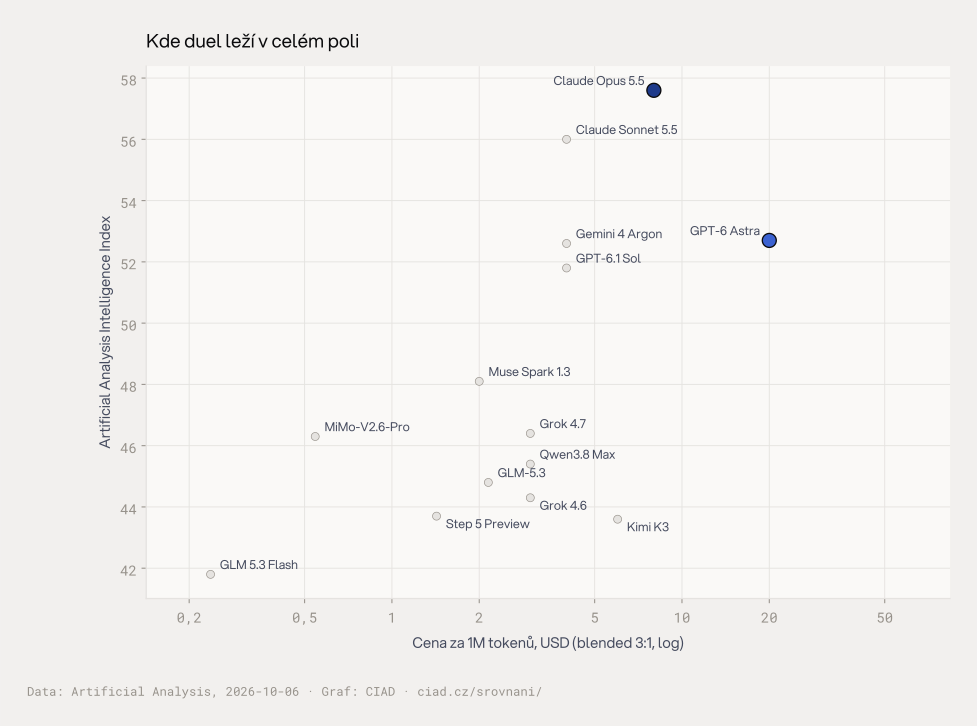 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Data ukazují vedení jednoho modelu
V souhrnném pohledu vede Claude Opus 5.5 s inteligencí 57,6, následuje GPT-6 Astra s inteligencí 52,7, přičemž předpočítaný rozdíl činí 4,9 bodu. Cena činí 8 u Claude Opus 5.5 a 20 u GPT-6 Astra, k čemuž patří předpočítaný poměr cen 2,5×. Rychlost dosahuje 96,4 u Claude Opus 5.5 a 64,1 u GPT-6 Astra, k čemuž patří předpočítaný poměr rychlostí 1,5×. Prodleva první odpovědi činí 489,35 u Claude Opus 5.5 a 186,72 u GPT-6 Astra.
V hloubkových zkouškách vede rovněž Claude Opus 5.5. Zkouška HLE měří expertní otázky napříč obory a je relevantní pro vědu a výzkum, přičemž výsledek činí 61,4 proti hodnotě 54,7. Zkouška SciCode měří programování vědeckých algoritmů a je relevantní pro vědu a výzkum, přičemž výsledek činí 66,9 proti hodnotě 56,5 a největší náskok činí 10,4 procentního bodu. Zkouška LCR měří porozumění dlouhému kontextu a je relevantní pro dlouhé dokumenty, přičemž výsledek činí 84,7 proti hodnotě 80,7.
Laboratoř není každodenní provoz
Vyšší inteligence 57,6 proti hodnotě 52,7 vypadá přesvědčivě, avšak pro reálnou práci rozhoduje skladba úloh. Hodnoty 61,4 a 54,7 ve zkoušce expertních otázek napříč obory naznačují jistější zvládání náročného dotazování ve vědě a výzkumu. Hodnoty 66,9 a 56,5 v programování vědeckých algoritmů ukazují sílu při přípravě výpočtů a zpracování dat, kde chyba stojí čas. Hodnoty 84,7 a 80,7 v porozumění dlouhému kontextu jsou důležité pro dlouhé dokumenty, smlouvy a zprávy.
Rychlost 96,4 proti hodnotě 64,1 a prodleva 489,35 proti hodnotě 186,72 si protiřečí, proto je nelze číst jako jednoduché „rychlejší znamená lepší“. Vysoký průtok pomáhá při dávkovém zpracování, zatímco kratší prodleva první odpovědi pomáhá při interaktivní práci. Ceně 8 proti ceně 20 s poměrem cen 2,5× rozumíme tak, že laboratorní prvenství se v provozu platí, a titulkům o převratu nevěříme.
Jak vybrat pro českou praxi
Pro vědu a výzkum dává smysl zkoušet nejprve Claude Opus 5.5, protože drží hodnoty 61,4 a 66,9, tedy vedení v expertních otázkách i ve vědeckých algoritmech. Pro dlouhé dokumenty je vodítkem hodnota 84,7 proti hodnotě 80,7, tedy mírnější odstup, takže volba závisí na délce podkladů a na kontrole výstupů. Podle mediálního monitoringu je užitečné sledovat i podmínky nasazení v regulovaném prostředí a pravidla pro původ textu.
Pro nákladově citlivé nasazení s velkým objemem je podstatná cena 8 proti ceně 20, tedy přibližně dvojnásobný odstup vyjádřený poměrem cen 2,5×. Kdo staví interaktivní službu, ať vedle rychlosti 96,4 a 64,1 váží i prodlevu 489,35 a 186,72. O univerzálním vítězi data nerozhodují, rozhoduje skladba práce, proto vybírejte podle převažující úlohy a ověřte chování na vlastních podkladech.
Časté dotazy
Který model je lepší pro vědu a výzkum podle dat?
Podle dat vychází lépe Claude Opus 5.5, když ve zkoušce expertních otázek drží 61,4 proti hodnotě 54,7 a v programování vědeckých algoritmů drží 66,9 proti hodnotě 56,5. Největší náskok činí 10,4 procentního bodu ve zkoušce SciCode. Souhrnná inteligence činí 57,6 proti hodnotě 52,7. Pro výzkumné nasazení ho proto testujte jako prvního.
Který model zvládá lépe dlouhé dokumenty?
Lépe vychází Claude Opus 5.5 s hodnotou 84,7 ve zkoušce porozumění dlouhému kontextu proti hodnotě 80,7. Odstup je těsný, takže pro smlouvy, zprávy a podklady rozhodne ověření na vlastních textech. Sledujte i rychlost 96,4 a 64,1 a prodlevu 489,35 a 186,72. Cena činí 8 proti ceně 20.
Který model se reálně vyplatí z hlediska ceny a rychlosti?
Z hlediska ceny vychází příznivěji Claude Opus 5.5 s cenou 8 proti ceně 20, přičemž poměr cen činí 2,5×. Rychlost činí 96,4 proti hodnotě 64,1 s poměrem rychlostí 1,5×, avšak prodleva činí 489,35 proti hodnotě 186,72. Volba tedy závisí na objemu zpracování a na tom, zda je důležitější průtok nebo rychlá první odpověď.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 6. října 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.