Dva modely, GPT-6 Astra od OpenAI a Qwen3.8 Max od Alibaby, stojí v září 2026 před přímým srovnáním. Data z benchmarků ukazují index inteligence 52,8 proti 45,4, kódování 76,9 proti 76,2, cenu 20 proti 3 USD za milion tokenů, rychlost 61,5 proti 40,4 tokenů za vteřinu a čas k prvnímu tokenu 187,48 proti 1,87 vteřiny. Článek sleduje souhrnné ukazatele i čtyři hloubkové testy a odvozuje, který model vyhovuje vědecké práci, agentům, terminálu, dlouhým dokumentům a hromadnému nasazení.
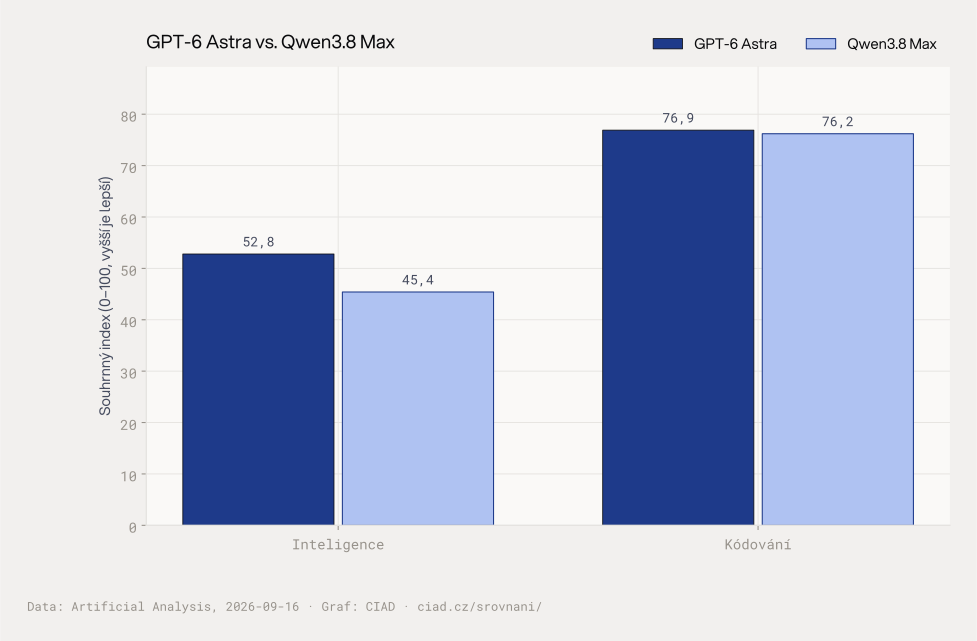 Souhrnné indexy: inteligence, kódování.
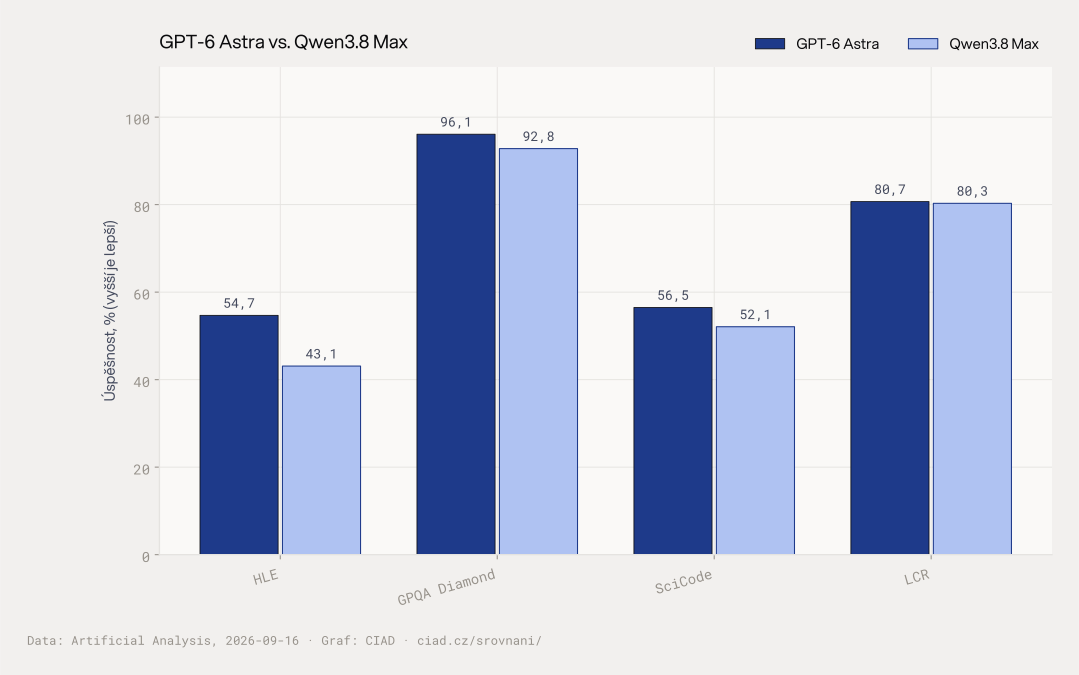 Hloubkové benchmarky: HLE, GPQA Diamond, SciCode, LCR.
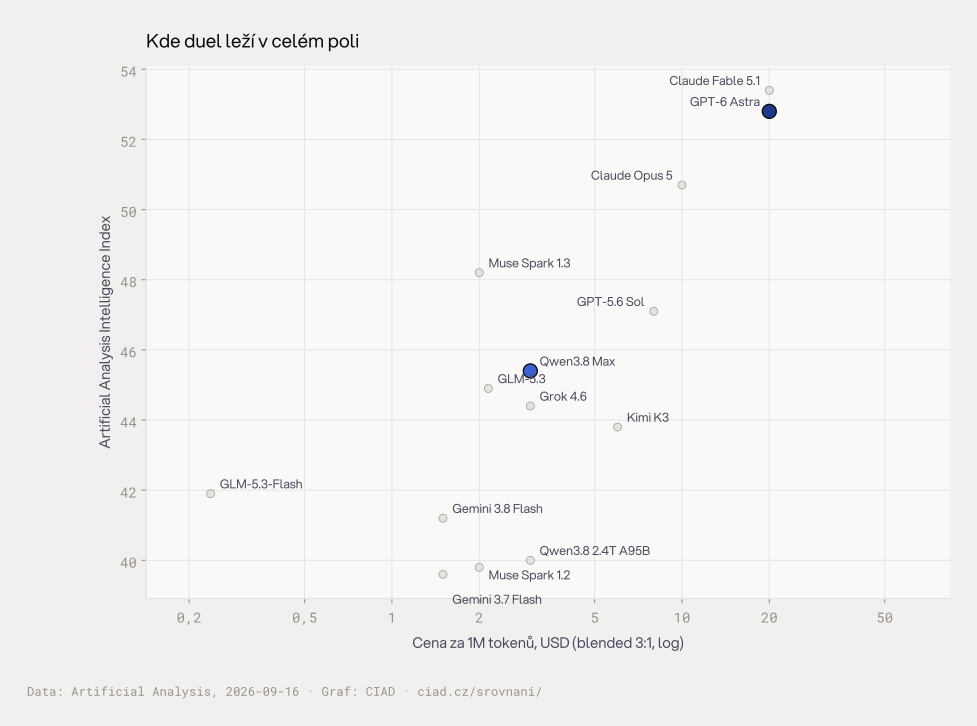 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Co ukazují souhrnné indexy a hloubkové testy
GPT-6 Astra vede v indexu inteligence hodnotou 52,8 oproti 45,4 u Qwen3.8 Max, což odpovídá předpočítanému rozdílu 7,4 bodu. V kódování se modely blíží: 76,9 proti 76,2. Hloubkové benchmarky potvrzují vedoucí pozici GPT-6 Astra ve všech čtyřech měřených oblastech. Největší propast klape v HLE, kde GPT-6 Astra dosahuje 54,7 % úspěšnosti a Qwen3.8 Max 43,1 %, tedy předpočítaný náskok 11,6 procentního bodu. HLE měří expertní otázky napříč obory a výsledek signalizuje silnější schopnost syntetizovat znalosti v nových situacích, což je relevantní pro vědu a výzkum.
Ve vědeckých otázkách doktorandské úrovně GPQA Diamond skóre GPT-6 Astra 96,1 % těsně před 92,8 % Qwen3.8 Max, oba modely tak pokrývají většinu složitých úloh. U programování vědeckých algoritmů SciCode vede GPT-6 Astra 56,5 % proti 52,1 %, což pro autonomní agenti znamená lepší spolehlivost při generování numerických rutin. Porozumění dlouhému kontextu LCR je téměř shodné: 80,7 % proti 80,3 %, takže pro práci s rozsáhlými dokumenty oba modely dostatečně vyhovují.
Kritická interpretace čísel pro reálný provoz
Cenový rozdíl je rozhodující: GPT-6 Astra stojí 20 USD za milion tokenů, Qwen3.8 Max 3 USD, což dává předpočítaný poměr cen 6,7×. U masového nasazení agentů nebo zpracování velkých objemů textu se náklady násobí a výhoda Qwenu se stává ekonomicky dominantní. Rychlost generování tokenů je u GPT-6 Astra 61,5 tokenů za vteřinu, u Qwen3.8 Max 40,4 tokenů za vteřinu, předpočítaný poměr rychlostí 1,5×. Čas k prvnímu tokenu TTFT klade GPT-6 Astra na 187,48 vteřin, Qwen3.8 Max na 1,87 vteřiny · pro interaktivní práci v terminálu a chatové rozhraní je Qwen3.8 Max řádově responzivnější.
Laboratorní benchmarky neodrážejí plně provozní realitu. Vysoké skóre GPQA Diamond 96,1 % a 92,8 % neznamená, že modely bezpečně nahradí vědeckou recenzi; měří znalostní retrieval, ne experimentální validaci. Podobně SciCode 56,5 % a 52,1 % testuje implementaci známých algoritmů, ne návrh nových. HLE 54,7 % a 43,1 % odráží schopnost odpovědět na expertní otázky, ne schopnost vést výzkum. LCR 80,7 % a 80,3 % potvrzuje paměť kontextu, ale neříká nic o přesnosti citací v reálných dokumentech. Pro dodržování zadání v produkci platí, že menší model s rychlejší odezvou a nižší cenou umožňuje více iterací a lepší ladění promptů.
Doporučení pro české firmy a organizace
Pro vědecké týmy a výzkumné laboratoře, kde záleží na maximální přesnosti syntézy znalostí a složitosti kódu, je GPT-6 Astra přiměřenou volbou i přes vyšší náklady a pomalejší odezvu. Jeho vedoucí výsledky v HLE, GPQA Diamond a SciCode podporují úlohy, kde chyba stojí více než výpočetní čas. Pro produkční nasazení autonomních agentů, masové zpracování dokumentů, chatové rozhraní a práci v terminálu nabízí Qwen3.8 Max lepší poměr výkonu k nákladům: srovnatelné kódování, téměř shodné porozumění dlouhému kontextu, řádově nižší cenu a řádově rychlejší první token.
Organizace by měly model vybrat podle typu úlohy, ne podle univerzálního pořadí. Pokud projekt vyžaduje hloubkový odborný rozum a toleruje latenci, GPT-6 Astra vrátí investici kvalitou výstupů. Pokud projekt vyžaduje vysoký propust, nízkou latenci a horizontální škálování, Qwen3.8 Max uvolní rozpočet pro infrastrukturu a iterace. Kombinace obou modelů v kaskádě · Qwen pro triáž a hromadnou práci, GPT-6 pro finální syntézu · může být pro české firmy nejefektivnější strategií.
Časté dotazy
Který model je pro vědecký výzkum vhodnější?
GPT-6 Astra dosahuje v GPQA Diamond 96,1 % a v HLE 54,7 %, Qwen3.8 Max 92,8 % a 43,1 %. Vyšší skóre v expertních otázkách a vědeckém rozumování dává GPT-6 Astra přednost pro syntézu znalostí a složité analytické úlohy, kde se platí přesnost před rychlostí a cenou.
Vyplatí se platit 6,7× více za GPT-6 Astra?
Cena GPT-6 Astra je 20 USD za milion tokenů, Qwen3.8 Max 3 USD. Pokud úloha vyžaduje maximální inteligenci 52,8 a nejvyšší HLE 54,7 %, investice se vrátí kvalitou. Pro hromadné nasazení agentů, chaty a terminálovou práci, kde stačí kódování 76,2 a LCR 80,3 %, Qwen3.8 Max dává řádově lepší ekonomiku.
Jak se modely liší v rychlosti odezvy pro interaktivní práci?
TTFT GPT-6 Astra je 187,48 vteřin, Qwen3.8 Max 1,87 vteřiny. Rychlost generování tokenů: 61,5 proti 40,4 tokenů za vteřinu. Pro chat, terminál a agenty s lidskou zpětnou vazbou je Qwen3.8 Max prakticky jedinou použitelnou volbou; GPT-6 Astra slouží k dávkovým úlohám, kde latence nehraje roli.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 16. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.