Článek srovnává dva flagshipové modely září 2026: Claude Opus 5.5 od Anthropic a Qwen3.8 Max od Alibaby. Data pocházejí z jednotné sady měření indexu inteligence a tří hloubkových benchmarků HLE, SciCode a LCR, doplněných cenou za milion tokenů. Anthropic v týdnu 24. září představil Opus 5.5 for Work a projekt Swap pro agentní obchodování, Alibaba tichě nasazuje Qwen3.8 Max do cloudu. Srovnání ukazuje, kde se vyšší cena Claudu odrazí ve výsledcích a kde ne.
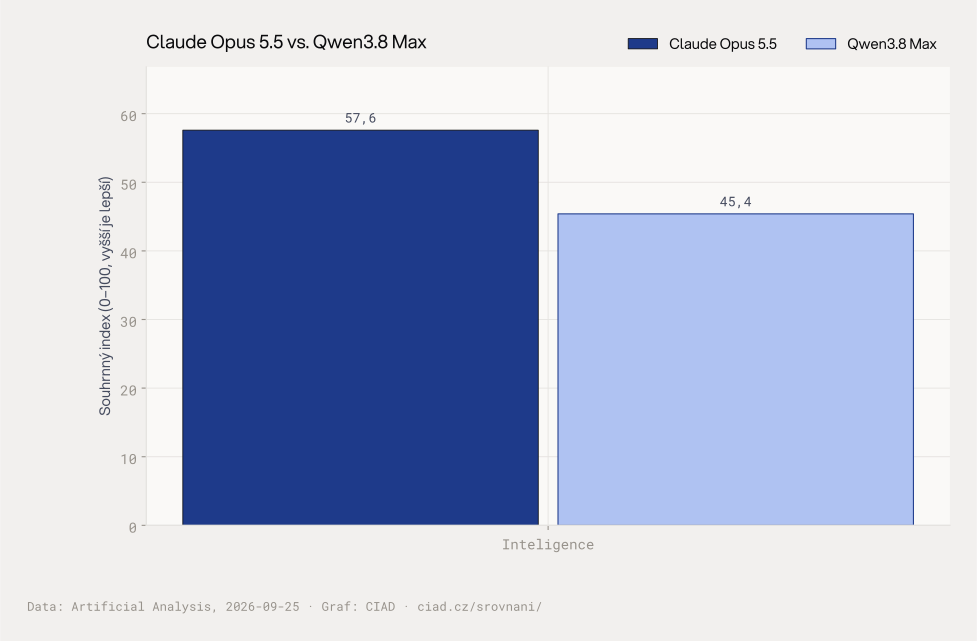 Souhrnné indexy: inteligence.
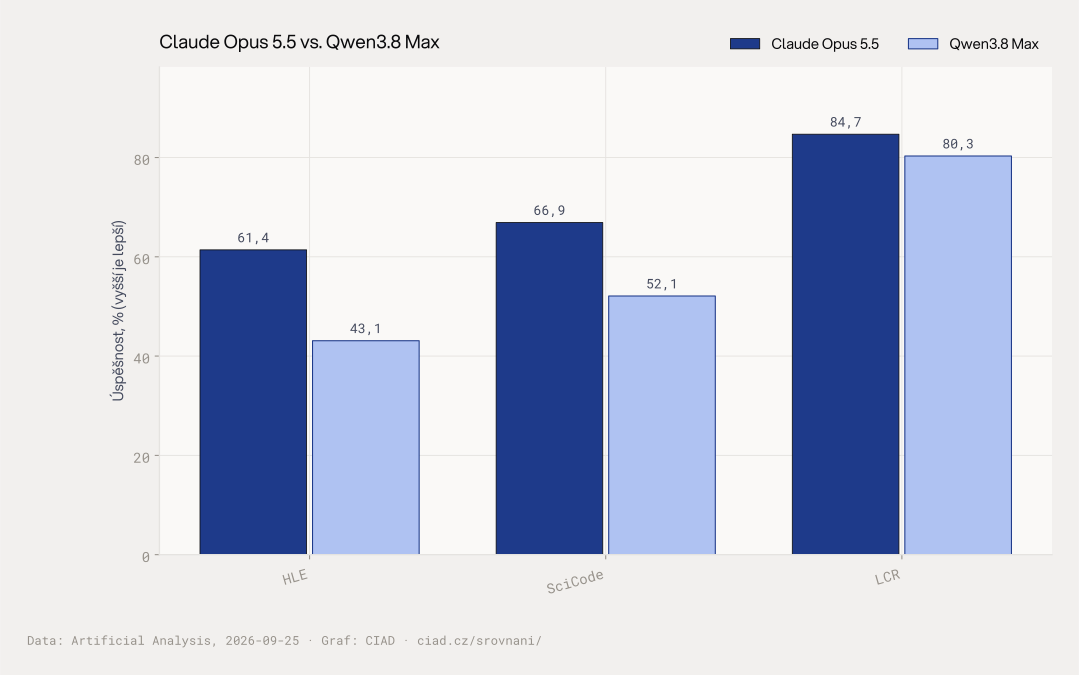 Hloubkové benchmarky: HLE, SciCode, LCR.
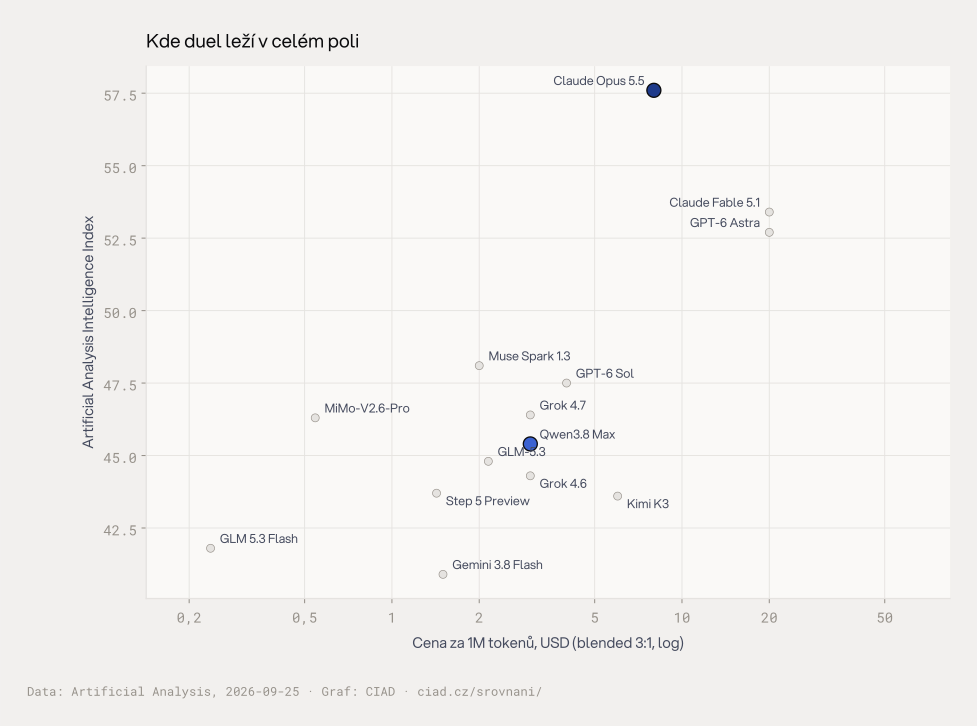 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Co ukazují index inteligence a benchmarky
Index inteligence Claude Opus 5.5 dosahuje 57,6 bodů, Qwen3.8 Max 45,4 bodů, rozdíl činí 12,2 bodu podle předpočítané hodnoty. Tento souhrný ukazatel odráží celkovou kognitivní kapacitu modelu a je relevantní pro rozhodování o univerzálním nasazení napříč úkoly.
Benchmark HLE měří úspěšnost u expertních otázek napříč obory (Humanity’s Last Exam). Claude Opus 5.5 dosahuje 61,4 %, Qwen3.8 Max 43,1 %, největší náskok Claudu je 18,3 procentního bodu podle předpočítané hodnoty. Výsledek je klíčový pro vědu a výzkum, kde model musí syntetizovat znalosti z mnoha domén.
Benchmark SciCode testuje programování vědeckých algoritmů. Claude Opus 5.5 dosahuje 66,9 %, Qwen3.8 Max 52,1 %. Rozdíl signalizuje výhodu Claudu při implementaci složitých matematických a simulačních úloh, typických pro výzkumné týmy a R&D oddělení.
Benchmark LCR zkoumá porozumění dlouhému kontextu. Claude Opus 5.5 dosahuje 84,7 %, Qwen3.8 Max 80,3 %. Oba modely dosahují vysoké hodnoty, rozdíl je těsný, což pro praxi znamená, že při práci s dlouhými dokumenty a rozsáhlými kódovými bázemi oba modely dobře fungují.
Kritická interpretace výsledků pro praxi
Index inteligence je agregovaná metrika, která nemusí přesně odrážet výkon v konkrétním úkolu. Velký náskok v HLE ukazuje silnější schopenost odpovídat na expertní otázky, ale neautomaticky zaručuje lepší výkon v rutinním kódování nebo administrativních úkolech, kde se modely liší méně.
SciCode zaměřený na vědecké algoritmy je relevantní pro specifickou část vývoje software · numerické metody, simulace, datová analýza. Pro obecné inženýrství, webové vývojové zásobníky nebo DevOps úkoly tato metrika má omezenou prediktivní sílu. LCR skóre obou modelů se pohybuje v pásmu, kde je rozdíl 84,7 vs 80,3 v reálném provozu s dlouhými dokumenty často nezaznamenatelný.
Cenový poměr 2,7× podle předpočítané hodnoty (8 USD vs 3 USD za milion tokenů) znamená, že při vysokých objemech tokenů se nákladová diference rychle akumuluje. Vyšší cena Claudu se opraviňuje jen tam, kde je jeho náskok v HLE a SciCode rozhodující pro kvalitu výstupu a kde chyba stojí více než diference v nákladech na inference.
Co z toho plyne pro nasazení
Pro organizace zaměřené na vědecký výzkum, složité analytické úlohy a situace, kde se vyžaduje hluboké porozumění napříč obory, je Claude Opus 5.5 jasnou volbou navzdory vyšší ceně. Jeho vedení v HLE a SciCode se projeví v méně halucinacích při expertních dotazech a přesnějším kódu pro výpočetní vědu.
Pro firemy s velkými objemy textového zpracování, dlouhými dokumenty, zákaznickou podporou nebo interními knowledge bázemi nabízí Qwen3.8 Max přiměřený výkon v LCR (80,3 %) při třetině ceny. Pokud úkoly nevyžadují hluboké expertní odvozování, ale spíše extrakci, shrnutí a klasifikaci v rozsáhlých datech, poměr cena/výkon směřuje k Qwenu.
Časté dotazy
Který model má vyšší index inteligence?
Claude Opus 5.5 dosahuje index inteligence 57,6, Qwen3.8 Max 45,4. Rozdíl je 12,2 bodu podle předpočítané hodnoty. Claude vede ve všech třech hloubkových benchmarcích: HLE 61,4 vs 43,1, SciCode 66,9 vs 52,1, LCR 84,7 vs 80,3.
Kolik stojí každý model za milion tokenů?
Claude Opus 5.5 stojí 8 USD za milion tokenů, Qwen3.8 Max 3 USD. Poměr cen dle předpočítané hodnoty je 2,7× v prospěch Qwenu. Při velkých objemech se rozdíl v nákladech rychle projeví.
Kde je největší rozdíl v benchmarcích?
Největší náskok Claudu je v benchmarku HLE (expertní otázky napříč obory) o 18,3 procentního bodu podle předpočítané hodnoty: 61,4 vs 43,1. U SciCode (vědecké algoritmy) je rozdíl menší, u LCR (dlouhý kontext) těsný.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 25. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.