V září 2026 vystupují proti sobě dva modely z opačných poloh trhu: Anthropicovo vlajkové Claude Opus 5.5 a Xiaomiho otevřený MiMo-V2.6-Pro. Data z Artificial Analysis ukazují index inteligence 57,6 u Clauda a 46,3 u MiMo při cenách 8 a 0,54 USD za milion tokenů. Tři hloubkové benchmarky · HLE pro expertní otázky, SciCode pro vědecké algoritmy a LCR pro dlouhý kontext · odhalují, kde se investice do dražšího modelu vracejí a kde ne.
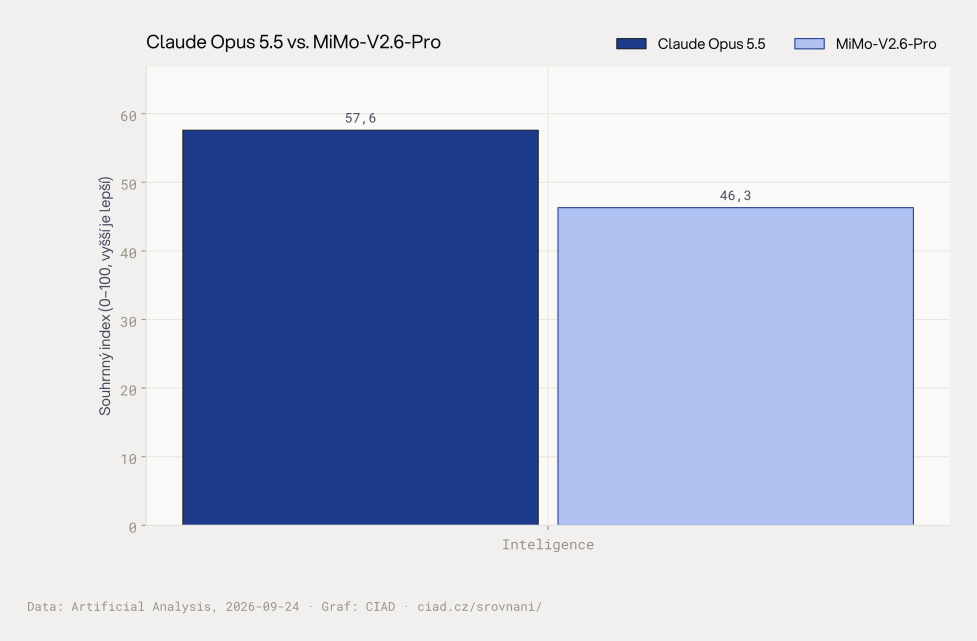 Souhrnné indexy: inteligence.
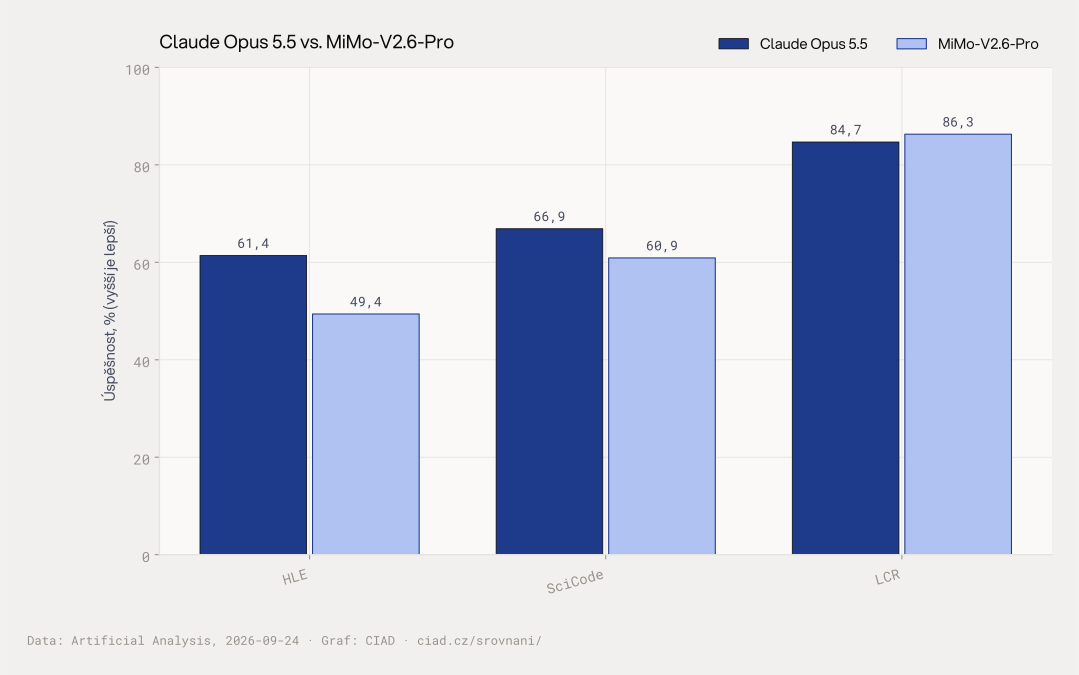 Hloubkové benchmarky: HLE, SciCode, LCR.
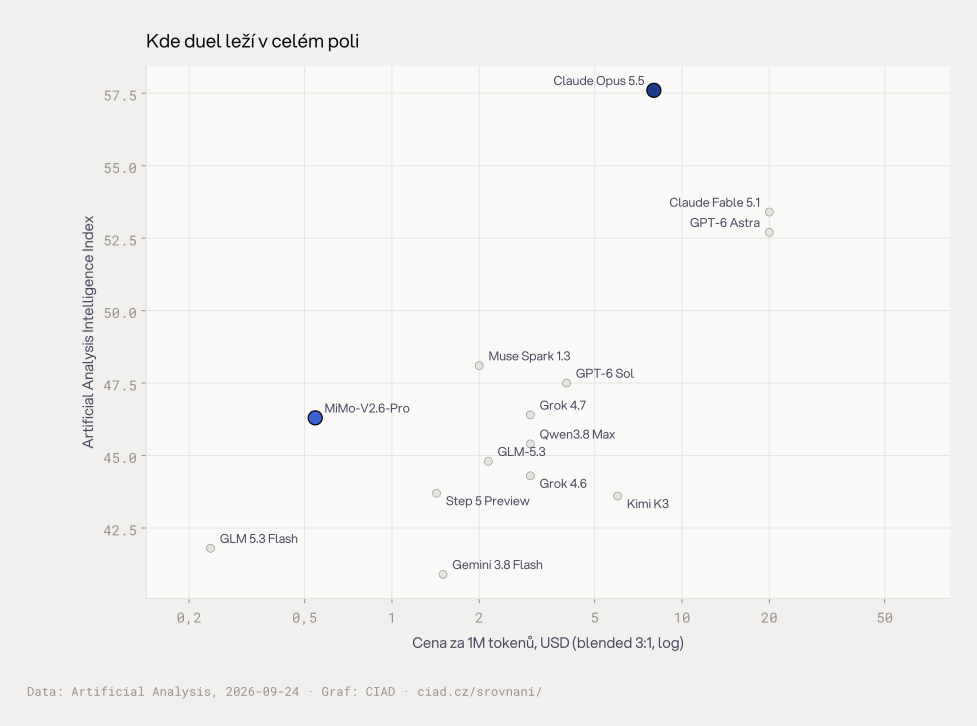 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Co hloubkové benchmarky odhalují o modelech
Celkový index inteligence Claude Opus 5.5 dosahuje 57,6 bodů, MiMo-V2.6-Pro se zastaví na 46,3 bodech. Rozdíl 11,3 bodu odpovídá cenovému poměru 14,7× · Claude stojí 8 USD za milion tokenů, MiMo pouhých 0,54 USD. Podle mediálního monitoringu Don’t Worry About the Vase Anthropic představuje Opus 5.5 jako „nejvýkonnější model podle některých měřidel“ a zároveň varuje před riziky neřízeného vývoje.
V benchmarku HLE, který měří expertní otázky napříč obory, Claude vede 61,4 proti 49,4 procentům · největší náskok 12 procentních bodů. To predisponuje Opus 5.5 pro vědecký výzkum a analytické úlohy vyžadující hluboké odborné znalosti. V SciCode, testujícím programování vědeckých algoritmů, Claude dosahuje 66,9 procent, MiMo 60,9 procent · těsnější, ale stále rozhodující výhoda pro vývoj specializovaného softwaru.
Překvapení přináší LCR, benchmark porozumění dlouhému kontextu, kde MiMo-V2.6-Pro dosahuje 86,3 procent a Claude 84,7 procent. Náskok 1,7 procentního bodu je jedinou metrikou, kde levnější model vede.
Kde benchmarky lžou a kde ne
Laboratorní benchmarky nejsou reálný provoz. HLE testuje znalostní otázky, ne schopnost vést výzkum od hypotézy k publikaci · i když podle tisku Anthropic Claude v biologické laboratoři objevil nový enzymový systém s CRISPR opakováním, lidé zůstávají v řídicí smyčce. SciCode měří implementaci známých algoritmů, ne architektonické rozhodování u nových systémů. LCR hodnotí extrakci informací z dlouhého textu, ne strategické čtení s cílem.
Cenový poměr 14,7× znamená, že za cenu jednoho Clauda můžete spustit téměř patnáct instancí MiMo. U úloh, kde LCR dominuje · masivní klasifikace dokumentů, monitorování regulací, zpracování logů · se levnější model vyplatí i při mírně nižší přesnosti. U jednorázových expertních analýz, kde chyba stojí týdny práce, se 11,3 bodů navíc v indexu inteligence a 12 bodů v HLE odplácí.
Mediální monitoring zaznamenal, že Anthropic a OpenAI souběžně snižují ceny 40 až 50 procent a zdůrazňují dodržování interních pravidel. To naznačuje, že cenový tlak od čínských modelů jako MiMo mění trh rychleji než benchmarky. Systémová karta Opus 5.5 a Frontier Red Team Research ukazují, že bezpečnostní testování neustále posouvá hranice toho, co modely umí a co nesmí.
Jak vybrat model pro konkrétní nasazení
České firmy a organizace by měly rozhodovat podle typu úlohy. Pro vědecký výzkum, farmakologické modelování, finanční rizikové analýzy a autonomní agenty vyžadující hluboké odborné úsudky je Claude Opus 5.5 jasnou volbou · index inteligence 57,6, HLE 61,4 a SciCode 66,9 podporují složité kognitivní řetězce. Cena 8 USD za milion tokenů je v těchto scénářích marginální oproti lidským nákladům.
Pro masivní zpracování textu · klasifikaci e-mailů, extrakci dat z tisíců smluv, monitorování legislativy, generování reportů ze strukturovaných dat · MiMo-V2.6-Pro nabízí LCR 86,3 při ceně 0,54 USD. Rozdíl 1,7 procentního bodu v LCR prospěje při velkých objemech více než 11,3 bodů v celkovém indexu. Hybridní strategie: Claude pro rozhodování, MiMo pro propracování dat.
Časté dotazy
Který model je chytřejší Claude Opus 5.5 nebo MiMo-V2.6-Pro?
Claude Opus 5.5 dosahuje indexu inteligence 57,6, MiMo-V2.6-Pro 46,3. Rozdíl 11,3 bodu se projeví nejvíce u expertních otázek HLE, kde Claude vede 61,4 proti 49,4 procentům, a u vědeckého programování SciCode s 66,9 proti 60,9 procentům. MiMo ale překvapivě vítězí v porozumění dlouhému kontextu LCR 86,3 proti 84,7.
Vyplatí se platit 14,7× více za Claude Opus 5.5 oproti MiMo-V2.6-Pro?
Za 8 USD Clauda získáte index inteligence 57,6 a dominantní výkon v HLE 61,4 a SciCode 66,9. Za 0,54 USD MiMo dostanete index 46,3 a nejlepší LCR 86,3. Pro jednorázové expertní analýzy se dražší model odplácí, pro masivní zpracování dokumentů je levnější model efektivnější.
Jak se Claude Opus 5.5 a MiMo-V2.6-Pro liší v práci s dlouhými dokumenty?
Benchmark LCR měří porozumění dlouhému kontextu. MiMo-V2.6-Pro dosahuje 86,3 procent úspěšnosti, Claude Opus 5.5 84,7 procent. Náskok 1,7 procentního bodu znamená, že levnější model lépe udržuje koherenci při masivním čtení archivů, právních svazků nebo technických manuálů.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 24. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.