V září 2026 se setkávají dva modely, které představují odlišné filozofie nasazení: Muse Spark 1.3 od Meta a Grok 4.7 od xAI. Data pokrývají souhrnný index inteligence, cenu za milion tokenů, rychlost generování a čas k prvnímu tokenu, doplněné třemi specializovanými benchmarci. Srovnání reaguje na vlnu novinek, kdy Meta rozšiřuje ekosystém Muse okolo trvalých virtuálních strojů a chytrých brýlí, zatímco xAI tlačí Grok do produkčních řad.
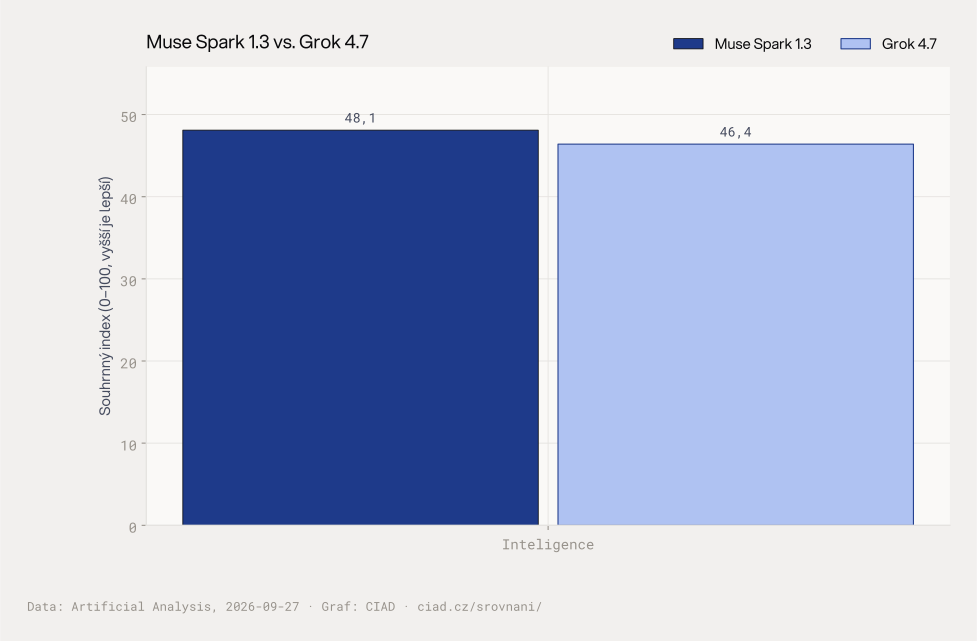 Souhrnné indexy: inteligence.
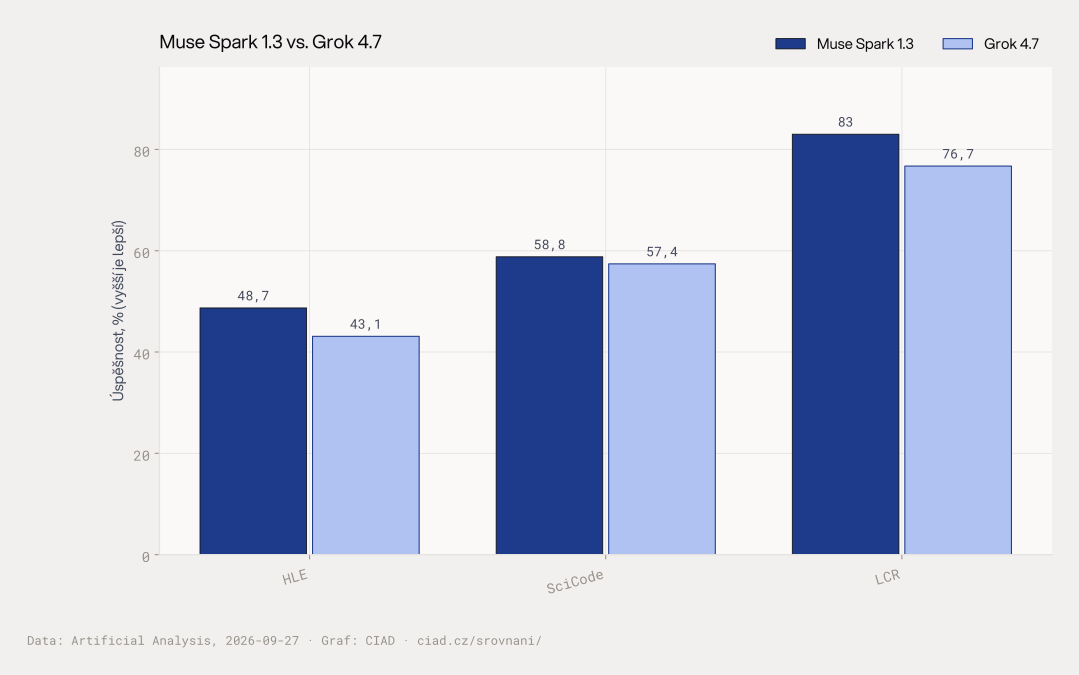 Hloubkové benchmarky: HLE, SciCode, LCR.
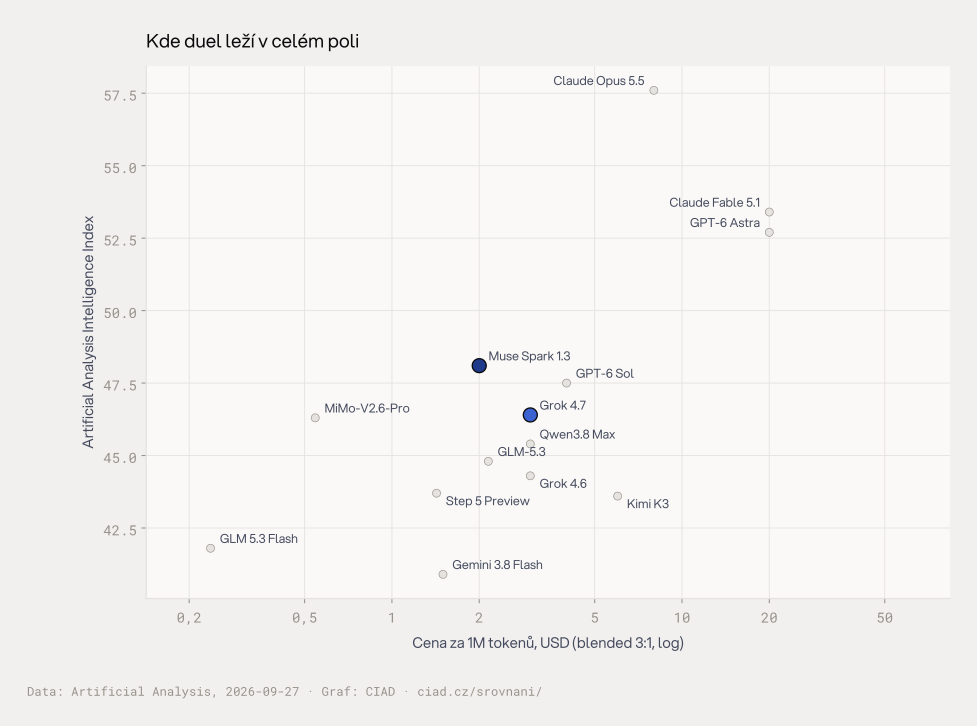 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Co ukazují souhrnná data
Muse Spark 1.3 dosahuje indexu inteligence 48,1, zatímco Grok 4.7 dosahuje 46,4, což odpovídá předpočítanému rozdílu 1,7 bodu ve prospěch modelu Meta. U ceny za milion tokenů je Muse Spark 1.3 uveden za 2 USD, Grok 4.7 za 3 USD, tedy poměr cen 1,5× v neprospěch Groku. Rychlost generování tokenů ukazuje výraznější rozdíl: Muse Spark 1.3 generuje 164,3 tokenů za sekundu, Grok 4.7 69,8 tokenů za sekundu, což je poměr rychlostí 2,4× v prospěch Muse. Naopak čas k prvnímu tokenu (TTFT) vede Grok 4.7 s 12,73 s oproti 26,82 s u Muse Spark 1.3, což pro konverzační rozhraní znamená rychlejší první odezvu.
Kritická interpretace benchmarků
Benchmark HLE (Humanity’s Last Exam) měří úspěšnost u expertních otázek napříč obory; Muse Spark 1.3 dosahuje 48,7 %, Grok 4.7 43,1 %. Výsledek je relevantní pro vědu a výzkum, kde se vyžaduje hluboké odborné úsudky. Benchmark SciCode testuje programování vědeckých algoritmů; Muse Spark 1.3 dosahuje 58,8 %, Grok 4.7 57,4 %, tedy těsný odstup pro úlohy autonomních agentů v výpočetní fyzice či bioinformatice. Benchmark LCR posuzuje porozumění dlouhému kontextu; Muse Spark 1.3 dosahuje 83 %, Grok 4.7 76,7 %, největší náskok 6,3 procentního bodu, což přímou souvislost má s prací s dlouhými dokumenty a rozsáhlými kódovými bázemi. Nižší TTFT u Groku 4.7 zlepšuje uživatelský dojem v chatu, ale neznamená vyšší kvalitu odpovědi u složitých úkolů.
Co z toho plyne pro praxi
Pro české firmy, které řeší náročné analytické úlohy, dlouhé dokumenty nebo vědecké výpočty, nabízí Muse Spark 1.3 vyšší inteligenci, nižší náklady a vyšší propustnost. Grok 4.7 se hodí tam, kde je kritická první odezva · například podpora operátorů v reálném čase nebo interaktivní asistence v terminálu. Pokud organizace nasazuje trvalé agenty s vlastním virtuálním strojem, jak uvádí mediální monitoring k Muse, může vyšší TTFT Muse být akceptovatelný v zaměnu za lepší výsledky v HLE a LCR. Univerzálního vítěze data nepodporují; volba závisí na tom, zda vážíte propustnost a hloubku, nebo latenci prvního tokenu.
Časté dotazy
Který model je levnější na milion tokenů?
Muse Spark 1.3 stojí 2 USD za milion tokenů, Grok 4.7 stojí 3 USD za milion tokenů, tedy Muse je levnější s poměrem cen 1,5×.
Který model má lepší čas k prvnímu tokenu?
Grok 4.7 dosahuje TTFT 12,73 s, Muse Spark 1.3 TTFT 26,82 s, tedy Grok nabízí rychlejší první odezvu.
Který model vede v porozumění dlouhému kontextu?
V benchmarku LCR dosahuje Muse Spark 1.3 83 %, Grok 4.7 76,7 %, největší náskok Muse je 6,3 procentního bodu.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 27. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.