Srovnáváme dva vlajkové modely září 2026: Grok 4.7 od xAI a Qwen3.8 Max od Alibaby. Data pocházejí z jednotné benchmarkové sady, která měří souhrnný index inteligence, cenu za milion tokenů, rychlost generování v tocích za vteřinu a čas k prvnímu tokenu. Doplňují je tři hloubkové testy zaměřené na expertní znalosti, vědecké kódování a dlouhý kontext. Cílem je ukázat, který model se vyplatí pro konkrétní typ nasazení, nikoli prohlašovat univerzálního vítěze.
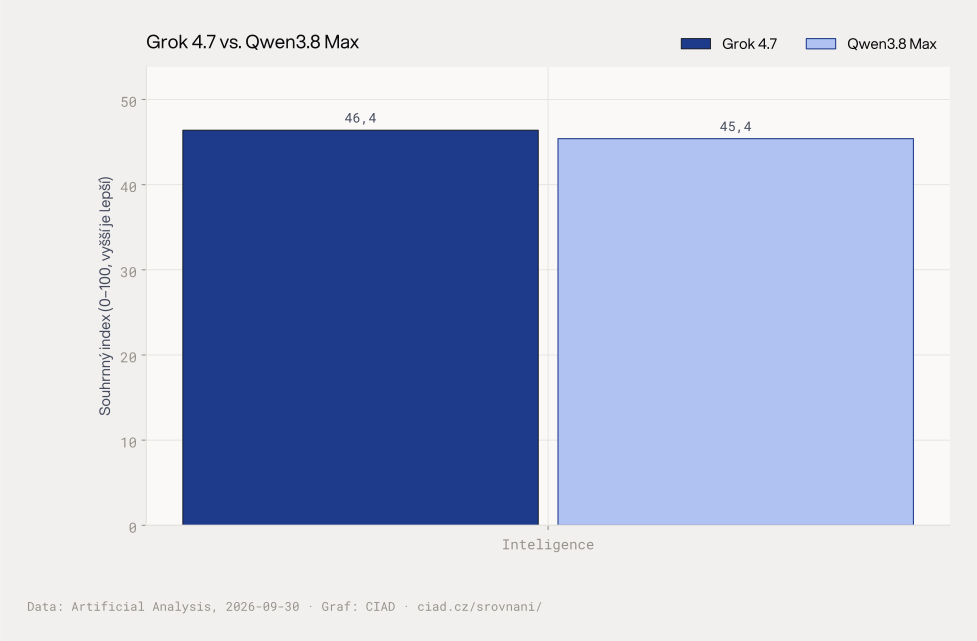 Souhrnné indexy: inteligence.
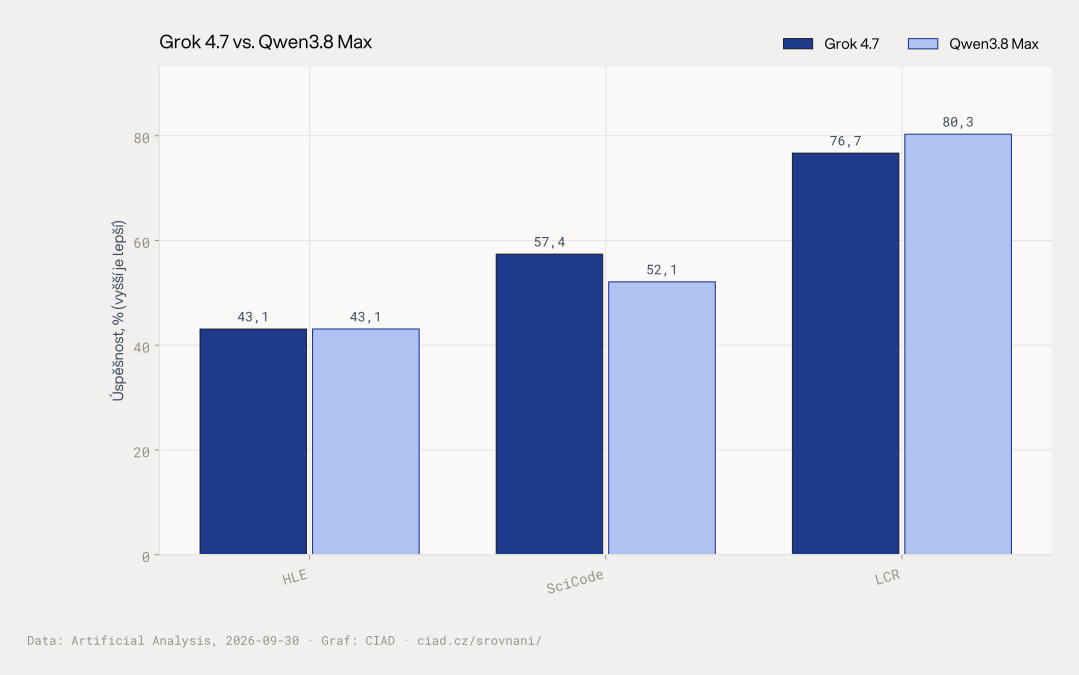 Hloubkové benchmarky: HLE, SciCode, LCR.
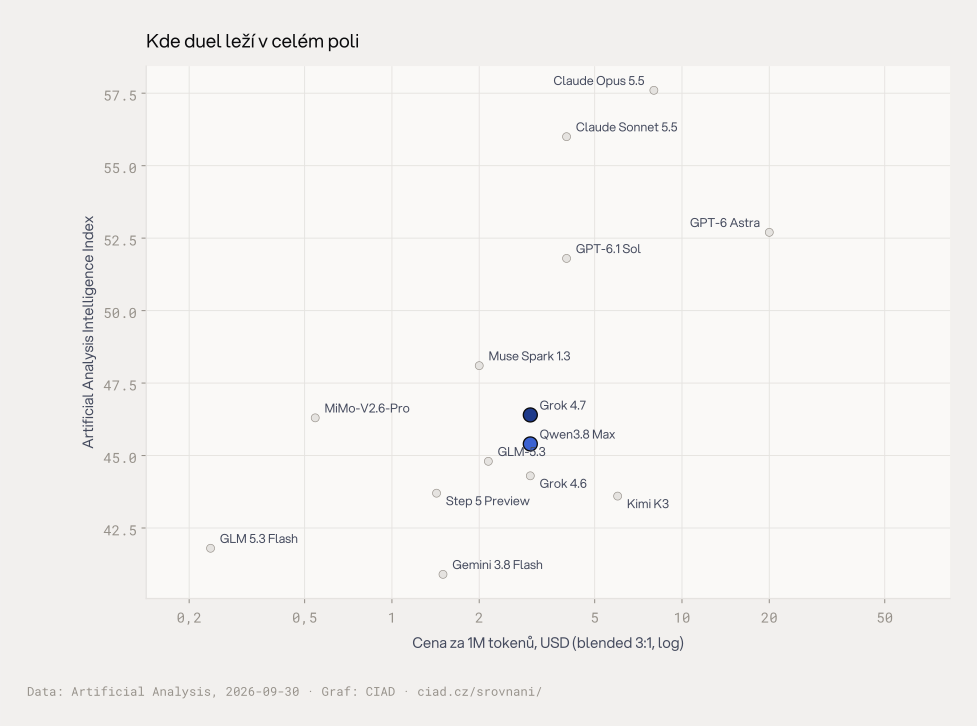 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Co ukazují souhrnné indexy a hloubkové testy
V souhrném indexu inteligence vede Grok 4.7 s hodnotou 46,4, Qwen3.8 Max následuje s 45,4, rozdíl je jeden bod. Cena za milion tokenů je u obou modelů identická, tři dolary. Rychlost generování se liší výrazně: Grok 4.7 dosahuje 84,4 tokenů za vteřinu, Qwen3.8 Max 40 tokenů za vteřinu, poměr rychlostí je 2,1×. Čas k prvnímu tokenu (TTFT) je u Qwen3.8 Max 1,84 sekundy, u Grok 4.7 22,57 sekundy, tedy Qwen odpovídá řádově dřív. V benchmarku HLE, který měří expertní otázky napříč obory (Humanity’s Last Exam), oba modely dosáhli shodné úspěšnosti 43,1 procenta. V SciCode, testu programování vědeckých algoritmů, Grok 4.7 dosáhl 57,4 procenta, Qwen3.8 Max 52,1 procenta, největší náskok Grok 4.7 je 5,3 procentního bodu. V LCR, testu porozumění dlouhému kontextu, Qwen3.8 Max vede s 80,3 procenta proti 76,7 procentu Grok 4.7, největší náskok Qwen3.8 Max je 3,7 procentního bodu.
Kritická interpretace pro reálné nasazení
Vysoký index inteligence Grok 4.7 a jeho rychlost generování predisponují model k úlohám, kde záleží na objemu vyprodukovaného textu za jednotku času · například hromadné zpracování dat, generování kódu v rozsáhlých bázích nebo dlouho běžící agentní smyčky. Naopak vysoký TTFT 22,57 sekund znamená, že první odpověď přichází s výrazným zpožděním, což v interaktivních aplikacích (chatboti, asistenční rozhraní) uživatelsky frustruje. Qwen3.8 Max s TTFT 1,84 sekundy je v tomto režimu o poznání responzivnější. Výsledek v LCR ukazuje, že Qwen3.8 Max lépe udržuje koherenci při velmi dlouhých vstupech, což je relevantní pro analýzu rozsáhlých dokumentů, právních smluv nebo technické dokumentace. Shodný výsledek v HLE naznačuje, že v široké expertní znalosti neexistuje praktický rozdíl. Laboratorní benchmarky neodrážejí náklady na infrastrukturu, kvóty dostupnosti ani chování při reálném šumu vstupů.
Co z toho plyne pro firmy a organizace
Pro české firmy, které řeší dávkové zpracování, vědecké výpočty nebo autonomní agenty s dlouhými běhy, je Grok 4.7 přirozenou volbou díky rychlosti tokenů a vyššímu skóre ve vědeckém kódování. Pokud je prioritou interaktivní uživatelská zkušenost, nízká latence prvního tokenu a práce s velkými kontexty (například právní audit, analýza reportů), Qwen3.8 Max nabízí výhodu. Identická cena za milion tokenů eliminuje ekonomický argument, rozhoduje pouze profil zatížení. Doporučujeme pilotní test na reprezentativní sadě vlastních úkolů před plným nasazením.
Časté dotazy
Který model je chytřejší podle indexu inteligence?
Grok 4.7 dosahuje indexu inteligence 46,4, Qwen3.8 Max 45,4, rozdíl je jeden bod. Oba modely mají stejnou cenu tři dolary za milion tokenů.
Proč je čas k prvnímu tokenu důležitý pro výběr modelu?
Qwen3.8 Max odpovídá za 1,84 sekundy, Grok 4.7 za 22,57 sekundy. V interaktivních aplikacích jako chatboti nebo asistenční rozhraní nižší TTFT znamená výrazně lepší uživatelský zážitek.
Který model lépe zvládá dlouhé dokumenty a rozsáhlé kontexty?
V benchmarku LCR, který měří porozumění dlouhému kontextu, Qwen3.8 Max dosáhl 80,3 procenta, Grok 4.7 76,7 procenta. Qwen3.8 Max má tedy výhodu při analýze rozsáhlých textů.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 30. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.