Dva velká jazyková modely Muse Spark 1.3 od Meta a Qwen3.8 Max od Alibaby vstupují do přímého srovnání na základě laboratorních benchmarků a provozních parametrů. Data pokrývají souhrnný index inteligence, specializované testy vědeckého kódování a porozumění dlouhému kontextu, dále cenu za milion tokenů, rychlost generování a latenci první odpovědi. Cílem je odhalit, který model se reálně vyplatí pro konkrétní typy nasazení v českém prostředí.
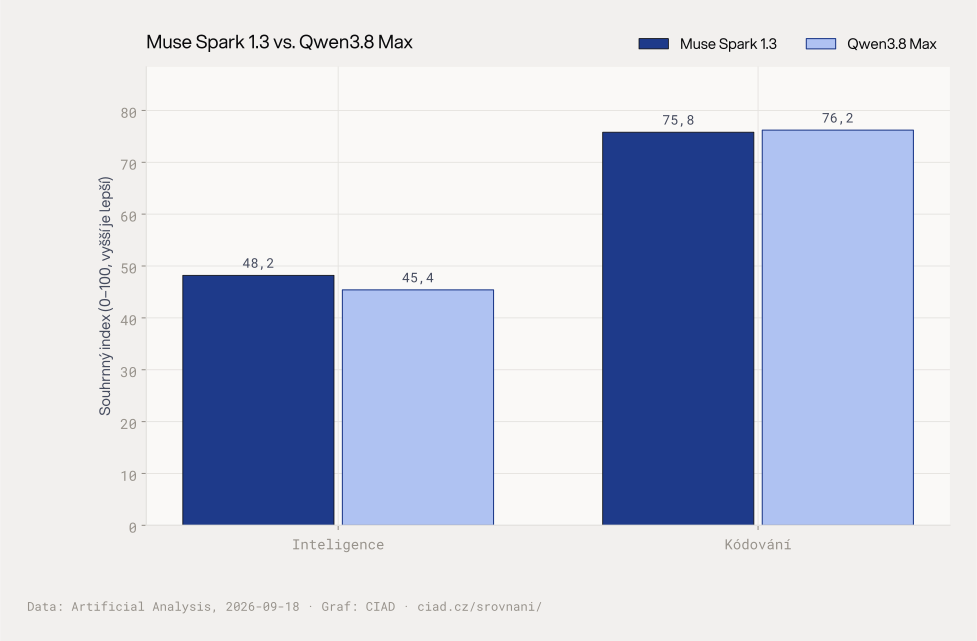 Souhrnné indexy: inteligence, kódování.
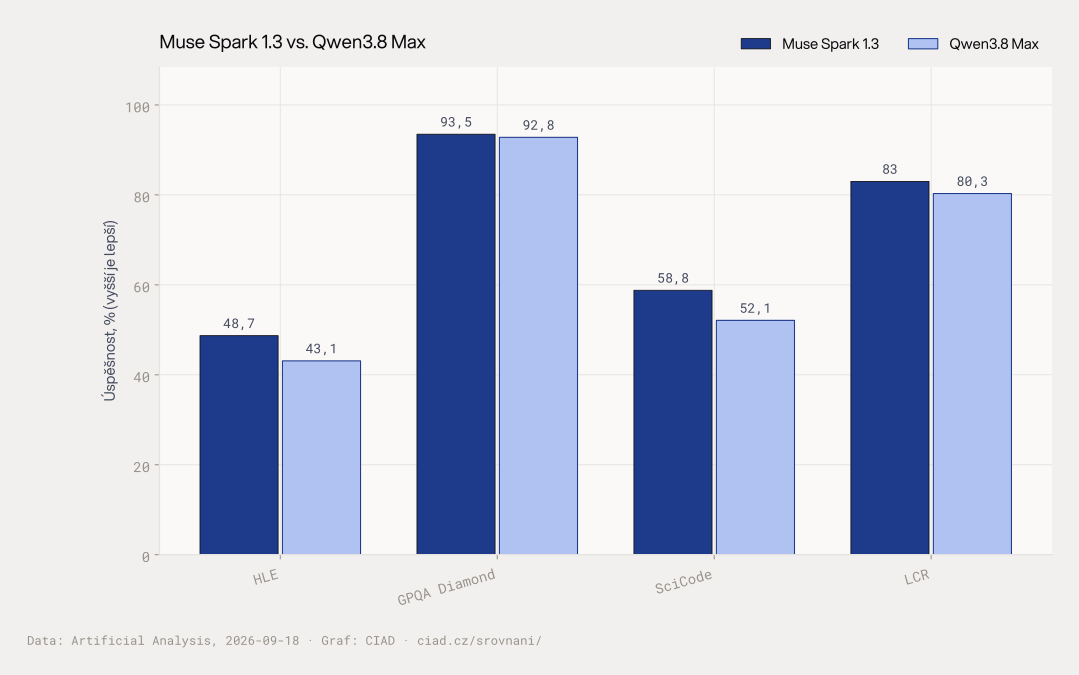 Hloubkové benchmarky: HLE, GPQA Diamond, SciCode, LCR.
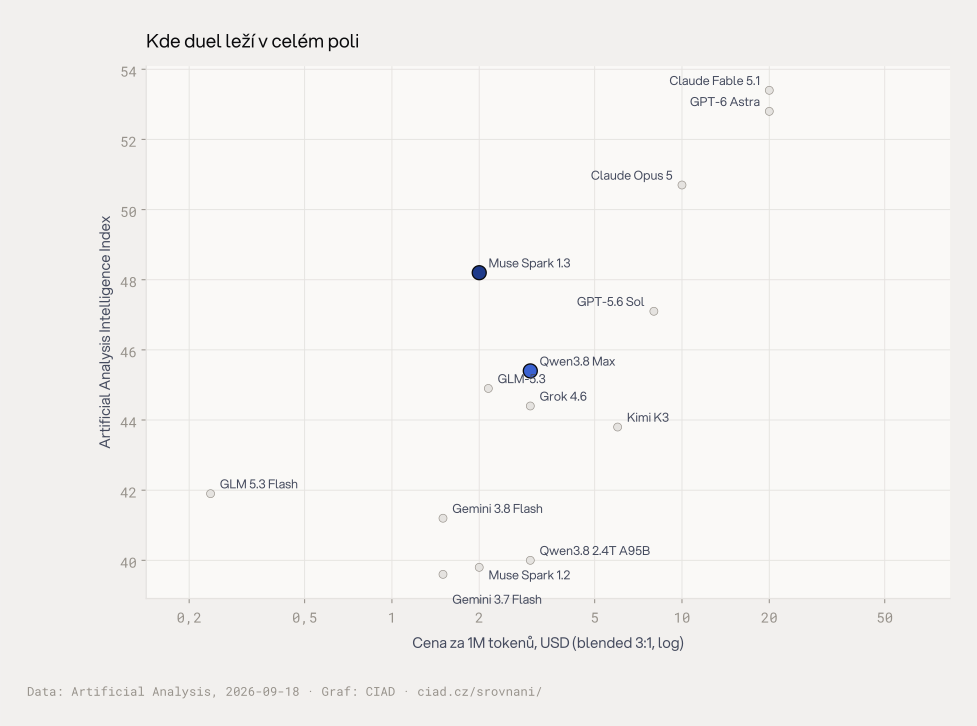 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Co ukazují souhrnné indexy a hloubkové testy
Muse Spark 1.3 dosahuje indexu inteligence 48,2 bodů, Qwen3.8 Max se zastaví na 45,4 bodech, rozdíl činí 2,8 bodu podle předpočítané hodnoty. V kódování je situace těsnější: Muse Spark 1.3 dosahuje 75,8 bodů, Qwen3.8 Max mírně vede s 76,2 body. U hloubkových benchmarků Muse Spark 1.3 vede ve všech čtyřech měřených disciplínách. Největší náskok je u SciCode, kde Muse Spark 1.3 dosahuje 58,8 procenta úspěšnosti proti 52,1 procentům Qwen3.8 Max, rozdíl 6,7 procentního bodu podle předpočítané hodnoty. U HLE dosahuje Muse Spark 1.3 48,7 procenta, Qwen3.8 Max 43,1 procenta. GPQA Diamond ukazuje těsný odstup 93,5 proti 92,8 procenta. LCR porozumění dlouhému kontextu vykazuje 83 proti 80,3 procenta.
Rychlost generování tokenů je u Muse Spark 1.3 242,1 tokenů za vteřinu, u Qwen3.8 Max 40,8 tokenů za vteřinu, poměr rychlostí 5,9× podle předpočítané hodnoty. Čas první odpovědi TTFT je u Qwen3.8 Max 1,77 vteřiny, u Muse Spark 1.3 24,24 vteřiny. Cena za milion tokenů u Muse Spark 1.3 je 2 USD, u Qwen3.8 Max 3 USD, poměr cen 1,5× podle předpočítané hodnoty.
Kritická interpretace laboratorních výsledků v praxi
Vysoký index inteligence Muse Spark 1.3 a převaha v HLE benchmarku expertních otázek napříč obory naznačují silnější schopnost řešit složité neformální úkoly a syntézu znalostí, což je relevantní pro vědu a výzkum kde se vyžaduje hluboké porozumění. GPQA Diamond s těsným odstupem 93,5 proti 92,8 procenta ukazuje, že oba modely zvládají vědecké otázky doktorandské úrovně na podobné úrovni, pro reálnou vědeckou práci je tedy rozdíl minimální. SciCode měří programování vědeckých algoritmů a zde 6,7 procentního bodu náskok Muse Spark 1.3 může znamenat lepší spolehlivost při implementaci numerických metod a simulací. LCR porozumění dlouhému kontextu s 83 proti 80,3 procenta dává Muse Spark 1.3 výhodu při práci s rozsáhlými dokumenty a codebázemi.
Rychlost generování 242,1 tokenů za vteřinu u Muse Spark 1.3 versus 40,8 tokenů za vteřinu u Qwen3.8 Max je pro dávkové zpracování a generování dlouhých výstupů rozhodující, avšak čas první odpovědi 24,24 vteřiny u Muse Spark 1.3 proti 1,77 vteřinám u Qwen3.8 Max dělá Qwen3.8 Max vhodnějším pro interaktivní chatová rozhraní a agenty vyžadující okamžitou reakci. Cena 2 USD za milion tokenů u Muse Spark 1.3 oproti 3 USD u Qwen3.8 Max vypadá výhodně, ale poměr cen 1,5× se projeví až při velkých objemech, kde se latence první odpovědi stane úzkým hrdlem uživatelského zážitku.
Praktický návod pro výběr modelu
Pro české firmy zaměřené na vědecký výzkum, vývoj algoritmů a zpracování dlouhých dokumentů je Muse Spark 1.3 přirozenou volbou díky vyšší inteligenci, lepším výsledkům v SciCode a LCR a rychlejšímu generování výstupů, i když musí počítat s výrazně delším čekáním na první token. Pro nasazení v chatbotech, zákaznické podpoře a autonomních agentech, kde rozhoduje latence první odpovědi a cena při menších objemech, nabízí Qwen3.8 Max lepší poměr ceny a uživatelského komfortu díky TTFT 1,77 vteřiny. Kódování je u obou modelů na podobné úrovni 75,8 versus 76,2 bodů, takže pro čisté programátorské úkoly bez vědeckého kontextu je rozdíl zanedbatelný.
Doporučujeme testovat oba modely na reprezentativní sadě vlastních úkolů před nasazením do produkce, protože laboratorní benchmarky neplně odrážejí specifické požadavky českého jazyka, doménové znalosti a integrační omezení. Grafy a podrobná data jsou k dispozici v původním zdroji CIAD.
Časté dotazy
Který model je rychlejší pro generování dlouhých textů?
Muse Spark 1.3 generuje 242,1 tokenů za vteřinu, Qwen3.8 Max 40,8 tokenů za vteřinu, poměr rychlostí je 5,9× podle předpočítané hodnoty. Pro dávkové zpracování a dlouhé výstupy je Muse Spark 1.3 výrazně rychlejší, avšak čas první odpovědi 24,24 vteřiny může zpozdit start generování.
Jak velký je rozdíl v ceně za milion tokenů?
Muse Spark 1.3 stojí 2 USD za milion tokenů, Qwen3.8 Max 3 USD za milion tokenů, poměr cen je 1,5× podle předpočítané hodnoty. Muse Spark 1.3 je levnější na jednotku objemu, což se projeví při velkých měsíčních spotřebách, u menších projektů může být rozdíl v absolutních nákladech minimální.
Který model lépe zvládá vědecké programování?
U benchmarku SciCode programování vědeckých algoritmů dosahuje Muse Spark 1.3 58,8 procenta úspěšnosti, Qwen3.8 Max 52,1 procenta, největší náskok Muse Spark 1.3 je 6,7 procentního bodu podle předpočítané hodnoty. Pro implementaci numerických metod a vědeckých simulací je Muse Spark 1.3 spolehlivější volba.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 18. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.