Srovnáváme dva čínské vlajkové modely, které v září 2026 definují hranice dostupné inteligence pro podnikové nasazení. Data pocházejí z jednotné benchmarkové sady: souhrnný index inteligence, index kódování, čtyři hloubkové testy a provozní parametry cena, rychlost a latence. Kontext je důležitý: Alibaba právě vydal Qwen3.8-Omni-Flash s milionovým kontextem a agentními schopnostmi, zatímco GLM-5.3 figuruje v otevřených artefaktech podle Interconnects.
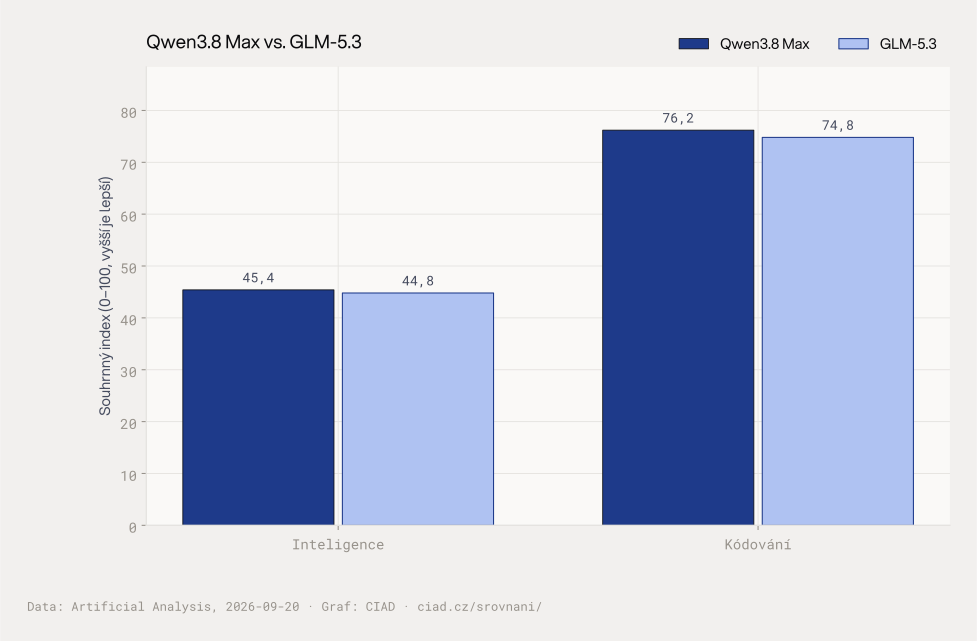 Souhrnné indexy: inteligence, kódování.
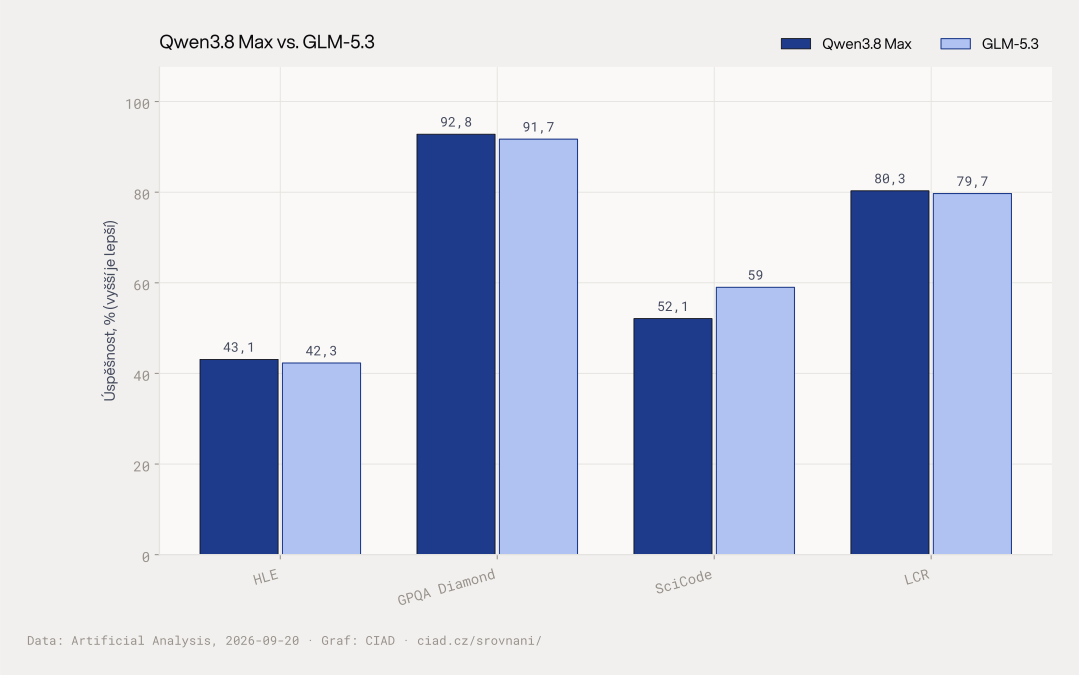 Hloubkové benchmarky: HLE, GPQA Diamond, SciCode, LCR.
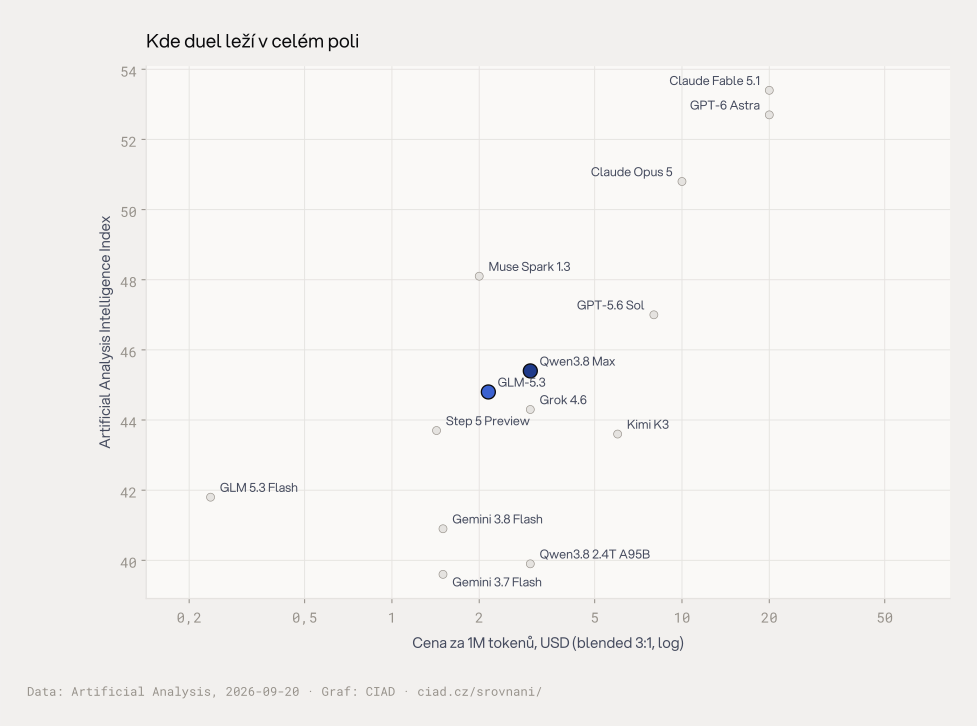 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Co ukazují souhrnné indexy a hloubkové benchmarky
V souhrném indexu inteligence Qwen3.8 Max dosahuje 45,4 bodů, GLM-5.3 44,8 bodů, rozdíl je 0,6 bodu. V kódování vede Qwen3.8 Max se 76,2 bodů před GLM-5.3 se 74,8 body. Hloubkové benchmarky odhalují odlišné silné stránky: Qwen3.8 Max dominuje v GPQA Diamond s 92,8 % úspěšnosti proti 91,7 %, což je největší náskok 1,1 procentního bodu a signalizuje výhodu ve vědeckém úvahování doktorandské úrovně. GLM-5.3 převrací tabulku v SciCode s 59 % proti 52,1 %, náskok 6,9 procentních bodů ukazuje lepší zvládání programování vědeckých algoritmů. V HLE a LCR jsou rozdíly minimální: 43,1 % proti 42,3 % a 80,3 % proti 79,7 %.
Kritická interpretace pro reálné nasazení
Index inteligence a GPQA Diamond napovídají, že Qwen3.8 Max lépe zvládá složité analytické úlohy a vědecké úvahy, což je relevantní pro výzkum a strategické plánování. SciCode výhoda GLM-5.3 se projeví při psaní numerických solverů, simulací a datových pipelineů. Rychlost generování tokenů je u Qwen3.8 Max dvakrát vyšší (38,3 vs 77,4 tokenů za sekundu), ale latence prvního tokenu je nižší (1,72 vs 2,65 vteřiny), což pro interaktivní agenty a terminálovou práci znamená citlivější odezvu. Cena za milion tokenů u GLM-5.3 je 2,15 USD proti 3 USD, poměr 1,4× zlevňuje rozsáhlé dávkové zpracování dlouhých dokumentů. Laboratorní benchmarky neukazují náklady na kontextové okno, tool use ani stabilitu v produkci.
Který model pro jaké nasazení
Pro české firmy zaměřené na výzkum, analytiku a agenty s nízkou latencí se vyplatí Qwen3.8 Max: vyšší inteligence, lepší vědecké úvahy, rychlejší první token a dvakrát rychlejší generování kompenzuje vyšší cenu. Pro týmy píšící vědecký kód, zpracovávající hromadné úlohy s dlouhým kontextem a optimalizující náklady je GLM-5.3 přirozenou volbou: silnější SciCode, nižší cena za token a dostatečná rychlost pro dávkové běhy. Univerzální vítěz data nepodporují, rozhoduje profil zatížení.
Časté dotazy
Který model má vyšší index inteligence a o kolik?
Qwen3.8 Max dosahuje 45,4 bodů, GLM-5.3 44,8 bodů, rozdíl je 0,6 bodu podle předpočítané hodnoty.
Jak se liší ceny za milion tokenů u obou modelů?
Qwen3.8 Max stojí 3 USD za milion tokenů, GLM-5.3 2,15 USD, poměr cen je 1,4× podle předpočítané hodnoty.
Který model je rychlejší v generování tokenů a jaký je rozdíl v latenci prvního tokenu?
Qwen3.8 Max generuje 38,3 tokenů za sekundu, GLM-5.3 77,4 tokenů za sekundu, poměr rychlostí je 2×. Latence prvního tokenu je u Qwen3.8 Max 1,72 vteřiny, u GLM-5.3 2,65 vteřiny.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 20. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.