Srovnáváme dva vlajkové modely září 2026: Qwen3.8 Max od Alibaby a Grok 4.6 od xAI. Obě modely stojí 3 USD za milion tokenů, liší se v indexu inteligence 45,4 proti 44,3, v kódování 76,2 versus 76,8 a zásadně v rychlosti generování 38,3 versus 57,6 tokenů za vteřinu i v latenci prvního tokenu 1,72 vteřiny proti 35,83 vteřinám. Data pocházejí z jednotných benchmarků.
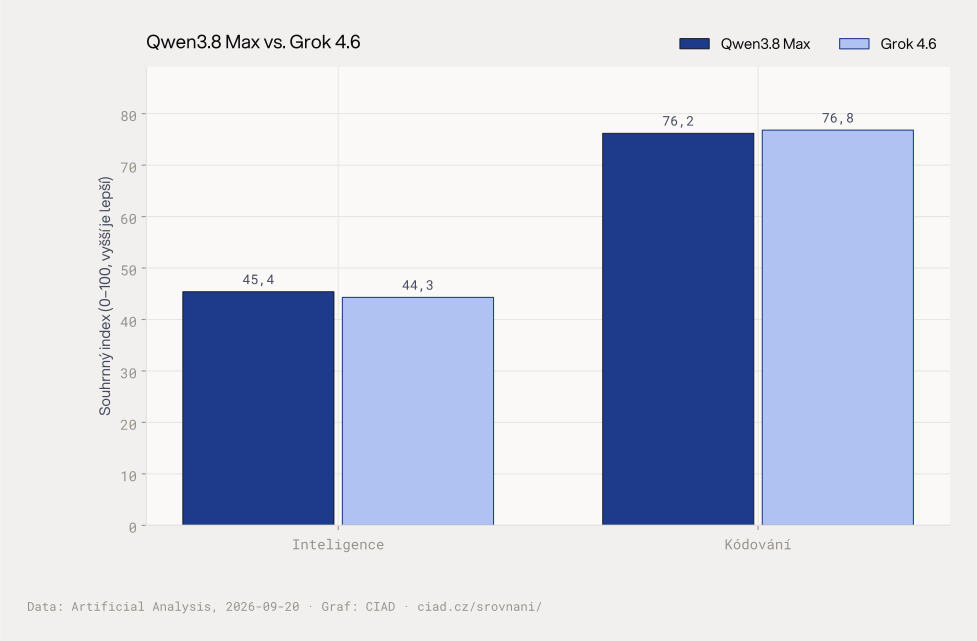 Souhrnné indexy: inteligence, kódování.
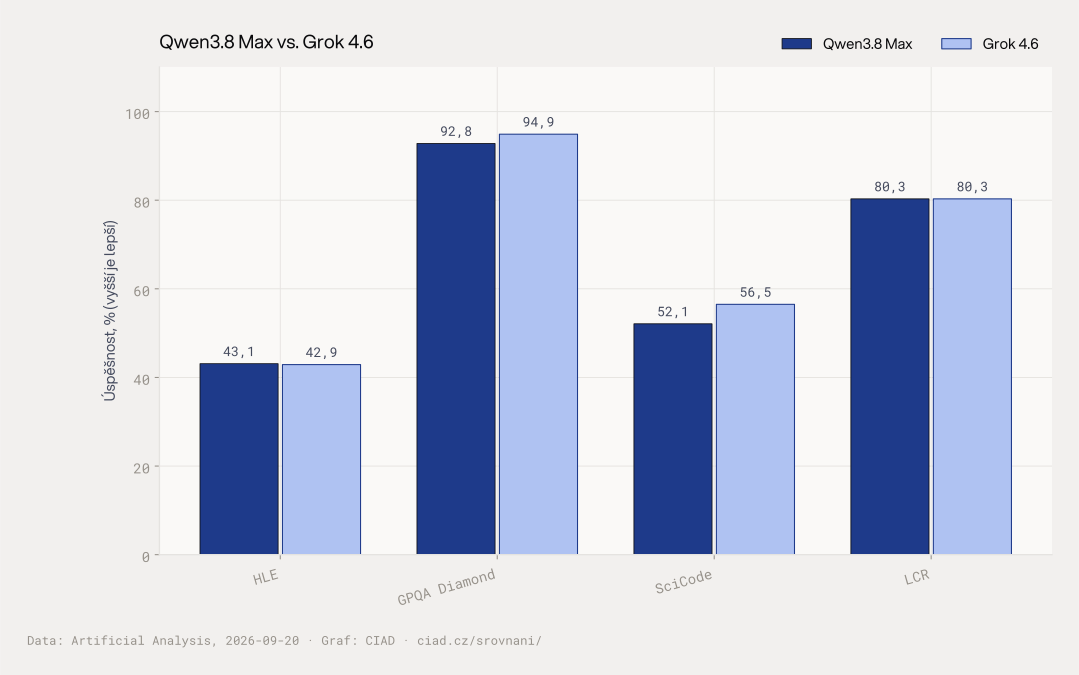 Hloubkové benchmarky: HLE, GPQA Diamond, SciCode, LCR.
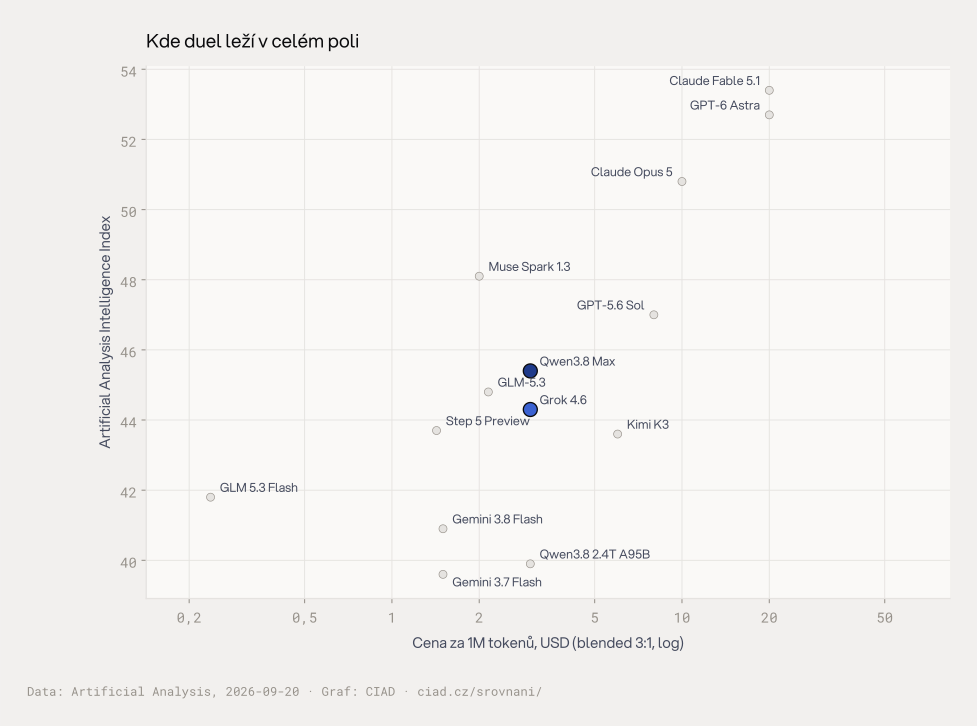 Duel v kontextu celého pole: cena (log) vs. Intelligence Index.
Souhrnné indexy a hloubkové benchmarky
V souhrném indexu inteligence vede Qwen3.8 Max s 45,4 body před Grok 4.6 s 44,3 body, rozdíl činí 1,1 bodu. V kódování je situace opačná: Grok 4.6 dosahuje 76,8 %, Qwen3.8 Max 76,2 %. Cena je u obou modelů identická 3 USD za milion tokenů, poměr cen tedy 1×. Rychlost generování tokenů je u Grok 4.6 57,6 tokenů za vteřinu, u Qwen3.8 Max 38,3 tokenů za vteřinu, poměr rychlostí 1,5× v prospěch Groku. Latence prvního tokenu (TTFT) je u Qwen3.8 Max 1,72 vteřiny, u Grok 4.6 35,83 vteřin.
Hloubkové benchmarky odhalují diferencovanější obraz. V HLE (expertní otázky napříč obory) vede Qwen3.8 Max s 43,1 % před Grok 4.6 s 42,9 %, náskok 0,2 procentního bodu. V GPQA Diamond (vědecké otázky doktorandské úrovně) vede Grok 4.6 s 94,9 % před Qwen3.8 Max s 92,8 %. V SciCode (programování vědeckých algoritmů) vede Grok 4.6 s 56,5 % před Qwen3.8 Max s 52,1 %, největší náskok 4,4 procentních bodů. V LCR (porozumění dlouhému kontextu) dosáhnou oba modely shodně 80,3 %.
Pro reálnou práci to znamená: vědecké úvahy a implementace vědeckých algoritmů směřují k Grok 4.6, expertní cross-domain otázky a dlouhé dokumenty k Qwen3.8 Max. Autonómní agenti v terminálu vyžadují nízkou latenci prvního tokenu, kde Qwen3.8 Max dominuje. Dodržování zadání v dlouhých kontextech je u obou modelů srovnatelné.
Kritická interpretace pro praxi
Rozdíl v indexu inteligence 1,1 bodu je v praxi marginální a nepřímo úměrný uživatelskému prožitku. Rozhodující je asymetrie rychlosti: Grok 4.6 generuje tokeny o 1,5× rychleji, ale jeho latence prvního tokenu 35,83 vteřin ho vylučuje z interaktivních scénářů · chat, asistent v IDE, živé dotazování. Qwen3.8 Max s 1,72 vteřiny umožňuje plynulý dialog. U dávkových úloh (generování reportů, refaktoring velkých kódových bází) se Grokova propustnost projeví výhodně.
Benchmarky GPQA Diamond a SciCode ukazují Grok 4.6 silnější v doménově specifických vědeckých úlohách, což koreluje s jeho zaměřením na technicko-vědeckou komunitu. HLE a LCR jsou u obou modelů v těsném rozsahu, což naznačuje, že obecné úvahování a dlouhý kontext již nejsou differenční faktory v této ligě. Laboratorní benchmarky neodrážejí plně produkční realitu: nezměřily odolnost proti adversariálním promptům, konzistenci formátování výstupů ani chování při kaskádovém volání nástrojů.
Podle mediálního monitoringu xAI v září vydal Grok Voice Transcribe 2.0 s dvakrát přesnějším rozpoznáváním řeči za 0,10 USD za hodinu, Alibaba představil Qwen3.8-Omni-Flash s 1M kontextem a agentním audio-video porozuměním. Anthropic podle agenturních zpráv obvinila čínské firmy z destilace modelů, USA mluví o průmyslovém měřítku. Tyto signály naznačují divergující ekosystémové priority: xAI buduje multimodální rozhraní, Alibaba agentní autonomii.
Doporučení pro české nasazení
Pro české firmy nasazující modely do interaktivních aplikací · zákaznická podpora, interní knowledge base, pair programming · je Qwen3.8 Max jasnou volbou díky latenci 1,72 vteřiny. Identická cena 3 USD za milion tokenů eliminuje finanční argument. Pro noční dávkové zpracování dat, masivní generování kódu, vědecké simulace a asynchronní pipeline je Grok 4.6 s 57,6 tokeny za vteřinu efektivnější. Výběr by měl vycházet z profilu zatížení, ne z univerzálního pořadí.
Organizace řešící vědecký výzkum nebo inženýrské výpočty získá u Grok 4.6 lepší výsledky v GPQA Diamond 94,9 % a SciCode 56,5 %. Týmy zaměřené na analýzu dlouhých smluv, legislativy nebo technické dokumentace najdou u obou modelů shodné 80,3 % v LCR, u Qwen3.8 Max navíc mírnou výhodu v HLE 43,1 %. Neexistuje univerzální vítěz · data podporují hybridní strategii: Qwen3.8 Max pro frontend interakce, Grok 4.6 pro backend výpočty.
Časté dotazy
Který model má nižší latenci prvního tokenu?
Qwen3.8 Max odpoví za 1,72 vteřiny, Grok 4.6 až po 35,83 vteřinách. Pro interaktivní chat, asistenty v IDE a živé dotazování je Qwen3.8 Max nezbytný. Grok 4.6 s rychlostí 57,6 tokenů za vteřinu vyhovuje dávkovým úlohám, kde na první odpovědi nezáleží.
Jsou ceny obou modelů shodné?
Ano, oba modely stojí 3 USD za milion tokenů, poměr cen je 1×. Finanční diferenciátor neexistuje, rozhoduje profil výkonu: Grok 4.6 generuje o 1,5× více tokenů za vteřinu, Qwen3.8 Max nabízí desetinásobně nižší latenci prvního tokenu 1,72 vteřiny proti 35,83 vteřinám.
Který model lépe zvládá vědecké programování a dlouhé dokumenty?
V SciCode (vědecké algoritmy) vede Grok 4.6 s 56,5 % před Qwen3.8 Max s 52,1 %. V GPQA Diamond (vědecké úvahy) vede Grok 4.6 s 94,9 % před 92,8 %. V LCR (dlouhý kontext) jsou oba modely shodně na 80,3 %. Pro vědecký kód a hlubokou analýzu textů je Grok 4.6 silnější, pro dlouhé dokumenty ekvivalentní.
ZDROJE DAT A METODIKA
Všechna čísla v tomto srovnání pocházejí z uvedených zdrojů k datu 20. září 2026. Grafy generuje institut CIAD přímo ze zdrojových dat; textová analýza čísla nikdy nedopočítává ani neodhaduje.